Tutorial
Die AetherSec Roadmap: Der echte Einstieg in Hacking
Drei Stufen, in dieser Reihenfolge. Erst C, dann C für Bytes und Dateien, dann NASM. Jede Lektion ist direkt anspringbar.
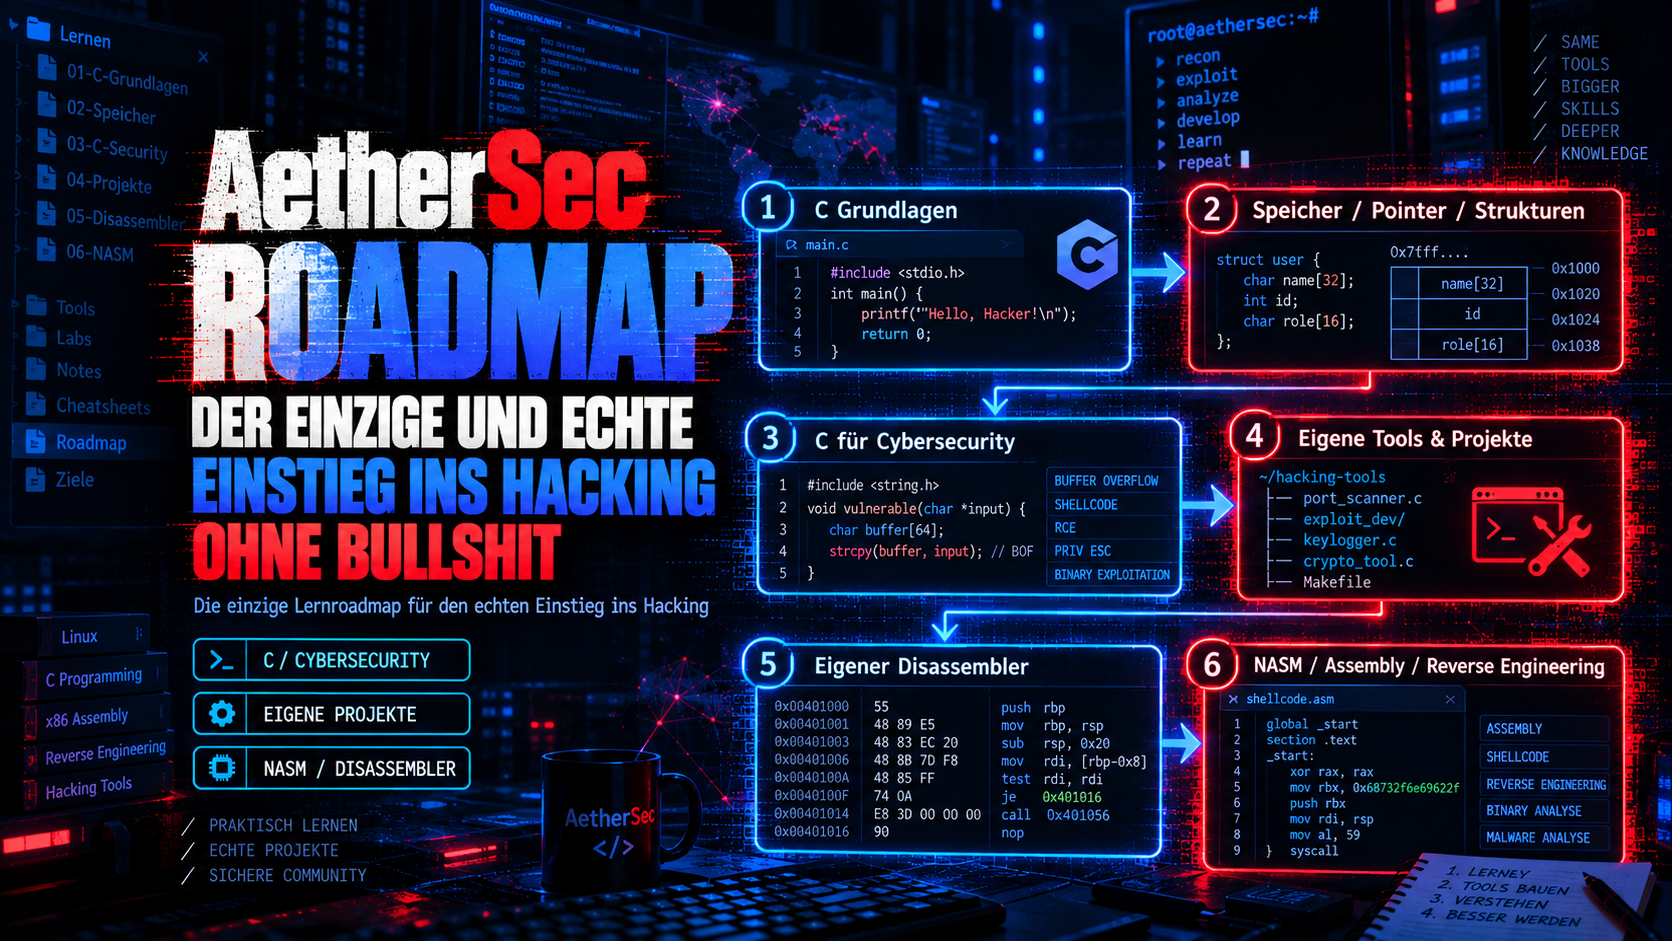
Hacking beginnt nicht bei einem Tool, das du nicht verstehst. Diese Roadmap ist der Einstieg, den ich selbst durchgehe: zuerst die Sprache, in der die Programme geschrieben sind, dann die Bytes, aus denen Dateien und Protokolle bestehen, und erst danach die Instruktionen, die der Compiler daraus macht.
Die Reihenfolge ist fest. C Grundlagen lernen, danach C für Cybersecurity lernen, danach NASM / Assembler lernen für Cybersecurity. Spring über die Liste direkt in eine Lektion. Jede Überschrift ist ein Anker.
Inhalt
- C Grundlagen lernen
- 01 – Hello World: Aufbau eines C-Programms
- 02 – Variablen und Typen
- 03 –
printfund Format-Strings - 04 – Operatoren
- 05 – Verzweigungen:
if,else,switch - 06 – Schleifen:
while,for,do while - 07 – Arrays
- 08 –
charund C-Strings - 09 – Funktionen
- 10 – Pointer Teil 1: Adressen,
&,* - 11 – Pointer als Parameter (Out-Parameter)
- 12 – Pointer und Arrays
- 13 –
structundtypedef - 14 –
stdint.h:uint8_t,uint32_t, … - 15 –
size_t - 16 –
mallocundfree(Heap) - 17 – Dateien:
fopen,fseek,ftell,fread,fclose - 18 –
errnound Fehlerbehandlung - 19 – Bits, Hex, Masken
- 20 – Casts und Rohbytes
- 21 –
constund Ownership - 22 – Mini-Hexdump (alles zusammen)
- C für Cybersecurity lernen
- NASM / Assembler lernen für Cybersecurity
- Level 0 — Werkzeugkasten
- Level 1 — Register verstehen
- Level 2 — Datenbewegung
- Level 3 — Arithmetic Patterns
- Level 4 — Vergleiche und Branches
- Level 5 — Kontrollfluss
- Level 6 — Calling Conventions
- Level 7 — Stackframes
- Level 8 — Lokale Variablen rekonstruieren
- Level 9 — Pointer
- Level 10 — Arrays
- Level 11 — Struct Reconstruction
- Level 12 — Strings
- Level 13 — Switch Statements
- Level 14 — Funktionen anhand des Verhaltens erkennen
- Level 15 — Compiler verstehen
- Level 16 — Optimierter Code
- Level 17 — Flags verstehen
- Level 18 — Signed vs Unsigned
- Level 19 — Function Pointers
- Level 20 — C++ Reverse Engineering
- Level 21 — Recursion
- Level 22 — Syscalls
- Level 23 — ELF Reverse Engineering
- Level 24 — PLT / GOT
- Level 25 — Dynamische Analyse
- Level 26 — Assembly ↔ C Mapping
- Level 27 — Blind Function Identification
- Level 28 — Architekturvergleich
- Level 29 — Kleine Crackmes
- Level 30 — Reverse Engineering Challenge
- Praxis-Session 1 — NASM / x86-64
C Grundlagen lernen
01 – Hello World: Aufbau eines C-Programms
Was passiert überhaupt?
- Du schreibst Quelltext (
.c) – lesbar für Menschen. - Der Compiler (
gcc) übersetzt das in Maschinencode (.exe). - Das Betriebssystem startet die
.exeund springt inmain.
01_hello_world.c --gcc--> 01_hello_world.exe --start--> main() läuftZeile für Zeile
#include <stdio.h>
#= Präprozessor-Direktive (wird vor dem eigentlichen Compile erledigt).include= „füge den Inhalt dieser Datei hier ein“.<stdio.h>= Standard-Header für Ein-/Ausgabe (printf,FILE, …).- Spitze Klammern
<>= suche in System-Include-Pfaden.
Ohne diese Zeile kennt der Compiler printf nicht.
int main(void)
int= Rückgabetyp:mainliefert eine ganze Zahl an das OS.main= fester Name: Startfunktion. Anders nennen geht nicht.(void)= „keine Parameter“.
Später siehst duint main(int argc, char *argv[])für Kommandozeilen-Argumente.{ ... }= Funktionskörper.
printf("…\n");
- Funktionsaufruf: Name, dann
(Argumente). "…"= String-Literal (Textkonstante).\n= Escape-Sequenz für NewLine (Zeilenumbruch).;= Ende der Anweisung – in C fast überall Pflicht.
return 0;
- Beendet
mainund gibt0zurück. - Konvention:
0= Erfolg, ungleich 0 = Fehler. - Später:
return EXIT_SUCCESS;ausstdlib.h(lesbarer, gleicher Sinn).
Wichtige Symbole in dieser Lektion
| Symbol | Name | Bedeutung |
|---|---|---|
# |
Hash | Präprozessor |
<> |
spitze Klammern | System-Header |
() |
runde Klammern | Parameterliste / Aufruf |
{} |
geschweifte Klammern | Block |
" |
Anführungszeichen | String |
\ |
Backslash | Escape in Strings (\n, \t, \\, \") |
; |
Semikolon | Anweisungsende |
// |
Zeilenkommentar | Rest der Zeile wird ignoriert |
/* */ |
Blockkommentar | alles dazwischen ignoriert |
Häufige Anfängerfehler
Mainstattmain(Groß/Klein zählt).- Semikolon vergessen.
printfohne#include <stdio.h>.\nvergessen → Ausgabe klebt an der nächsten Zeile / dem Prompt.
Der Weg dieses Beispiels ist eine Datei, ein Übersetzer und ein Rückgabewert. Du schreibst 01_hello_world.c, gcc macht daraus das Programm, und beim Start ruft das System main auf. In main steht printf(“Hallo C\n”). Die Funktion schreibt die sieben Zeichen H, a, l, l, o, Leerzeichen, C und danach das Newline. Der Format-String hat hier keinen Platzhalter, also kommt kein weiteres Argument. return 0 ist der Exit-Code: die Null sagt dem Betriebssystem, dass main ohne Fehler fertig ist. Fehlt das Include für stdio.h, kennt der Compiler printf nicht und bricht ab, bevor überhaupt ein Programm entsteht. Ein return 1 wäre dieselbe Funktion, nur mit einem anderen Code nach dem Drucken. Im Listing wird printf ein call und die Null ein mov in das Rückgaberegister, direkt vor ret.
Übung:
- Ersetze die TODOs.
- TODO 1: Header für printf einbinden: #include <stdio.h>
- TODO 2+3+4 stecken in main: - printf(“Hallo C\n”); - return 0;
- TODO 3: Mit printf eine Zeile ausgeben, z.B. “Hallo C\n”
- TODO 4: return 0; bedeutet Erfolg für das Betriebssystem // return 0; // }
02 – Variablen und Typen
Idee
Ein Typ sagt dem Compiler:
- wie viele Bytes der Wert braucht,
- wie er interpretiert wird (vorzeichenbehaftet? Fließkomma?),
- welche Operationen erlaubt sind.
Eine Variable ist ein benannter Speicherplatz mit Typ.
int score = 10;int= Typscore= Name== Zuweisung (schreibe rechts nach links in die Variable)10= Initialwert;= Ende
Häufige Basistypen (grobe Größen auf gängigen Desktop-Systemen)
| Typ | typ. Größe | Bedeutung |
|---|---|---|
char |
1 Byte | Zeichen oder kleines Integer |
int |
oft 4 Byte | ganze Zahl |
long |
4 oder 8 | größere ganze Zahl |
float |
4 | Fließkomma |
double |
8 | genaueres Fließkomma |
Wichtig für Low-Level später: Die genauen Größen von int/long sind nicht überall gleich.
Deshalb gibt es stdint.h (uint8_t, uint32_t, …) – Lektion 14.
Deklaration vs. Initialisierung
int a;        /* Deklaration: Speicher existiert, Wert UNDEFINIERT (Müll!) */
int b = 5;    /* Deklaration + Initialisierung */
a = 3;        /* spätere Zuweisung */
Nie uninitialisierte Variablen lesen.
const
const int MAX = 100;
/* MAX = 200;  <- verboten: const = „darf nach Init nicht geändert werden“ */
Namen-Regeln
- Buchstaben, Ziffern,
_ - darf nicht mit Ziffer beginnen
- Groß/Klein unterschiedlich:
Score≠score - keine Schlüsselwörter (
int,return, …)
sizeof
sizeof(int)     /* wie viele Bytes hat der Typ int? */
sizeof(score)   /* wie viele Bytes hat diese Variable? */
Ergebnis-Typ: size_t (Lektion 15). Zum Ausdrucken oft Cast auf unsigned long:
printf("%zu\n", sizeof(int));           /* C99, %zu für size_t */
printf("%lu\n", (unsigned long)sizeof(int));
Setze alter auf 20, pi auf 3.14159 und max_versuche auf 3. alter ist ein int, pi ein double mit acht Byte, max_versuche ein const int. Der Schritt alter++ liest 20, schreibt 21 an dieselbe Stelle und lässt pi unberührt. max_versuche bleibt 3, weil eine zweite Zuweisung auf ein const nicht übersetzt wird. sizeof(int) ist auf einem üblichen Desktop 4, sizeof(pi) ist 8. Die Ausgabe zeigt deshalb alter = 21, pi mit den Nachkommastellen und max = 3. Das Gegenbeispiel aus der Lektion ist int a ohne Initialisierung: der Speicher existiert, der Wert ist Müll, und ein printf davor druckt keine verlässliche Zahl. int b = 5 dagegen ist ab der ersten Zeile 5. Score und score sind zwei Namen. Ein späteres Disassembly zeigt für alter++ ein Addieren von 1 auf genau diesem Slot, nicht auf pi.
Übung:
- TODO 2: double-Variable “pi” mit 3.14159 anlegen
- TODO 3: const int “max_versuche” = 3
- TODO 4: alter um 1 erhöhen (alter = alter + 1; oder alter++;)
- TODO 5: Alles ausgeben: printf(“alter = %d\n”, alter); printf(“pi = %f\n”, pi); printf(“max = %d\n”, max_versuche); printf(“sizeof(int) = %zu\n”, sizeof(int)); Platzhalter: %d = int, %f = double/float, %zu = size_t
03 – `printf` und Format-Strings
Aufbau
printf("Text %d mehr Text\n", wert);
/*           ^^ Platzhalter     ^^^^ Argument */
Der Format-String enthält normalen Text und Platzhalter (%…).
Für jeden Platzhalter kommt (meist) ein Argument hinter dem String.
Wichtige Platzhalter
| Platzhalter | Typ | Beispielausgabe |
|---|---|---|
%d / %i |
int (dezimal) |
42 |
%u |
unsigned int | 42 |
%x |
unsigned hex klein | 2a |
%X |
unsigned hex groß | 2A |
%c |
ein Zeichen (char/int) |
A |
%s |
C-String (char *) |
hi |
%f |
double (auch für float) |
3.140000 |
%p |
Pointer-Adresse | 0x7ffc… |
%zu |
size_t |
8 |
%% |
Literal-Prozentzeichen | % |
Breite und Führungsnullen (für Hexdumps später)
printf("%02x", 10);   /* "0a" – mind. 2 Stellen, mit 0 auffüllen */
printf("%04x", 10);   /* "000a" */
printf("%3d", 7);     /* "  7" – Breite 3, Leerzeichen */
%02x siehst du in jedem Hexdump und in print_preview der OffSec-Übung 01.
Escape-Sequenzen in Strings
| Sequenz | Bedeutung |
|---|---|
\n |
neue Zeile |
\t |
Tab |
\\ |
ein Backslash |
\" |
Anführungszeichen im String |
\0 |
Nullbyte (String-Ende – Lektion 08) |
Mehrere Werte
int a = 1, b = 2;
printf("a=%d b=%d\n", a, b);
Reihenfolge der Argumente = Reihenfolge der Platzhalter.
PRIx8 und Co. (Ausblick)
Für uint8_t ist portable Ausgabe oft:
#include <inttypes.h>
#include <stdint.h>
uint8_t b = 0xab;
printf("%02" PRIx8 "\n", b);  /* wird zu etwas wie %02x */
Das brauchst du in den späteren OffSec-Übungen – hier erstmal %02x mit unsigned.
Nimm zahl gleich 255 und code gleich 65, das Zeichen A. printf mit %d druckt 255. %x druckt ff, weil 255 im Hexadezimalen FF ist. %02x druckt bei 255 ebenfalls ff, bei der kleineren Eingabe 10 dagegen 0a, mit führender Null auf zwei Stellen. %04x von 10 wird 000a, %3d von 7 wird zwei Leerzeichen und dann 7. %c von code druckt A, nicht die Ziffern 65. %s von name druckt die Zeichen bis zum Nullbyte. Eine Zeile mit zwei Platzhaltern, zahl=255 (0xff), verbraucht zwei Argumente in derselben Reihenfolge. Vertauschst du sie, steht der Zeichencode dort, wo die Zahl hingehört. Im Listing ist jedes Prozentzeichen ein Argument, das der Compiler in die Aufrufregister legt, bevor er printf ruft.
Übung:
- TODO 1: zahl dezimal ausgeben (%d)
- TODO 2: zahl hexadezimal ausgeben (%x) – Erwartung: ff
- TODO 3: zahl mit %02x (bei 255 egal, bei kleinen Werten führende 0)
- TODO 4: code als Zeichen (%c) – Erwartung: A
- TODO 5: name als String (%s)
- TODO 6: faktor mit %f
- TODO 7: Eine Zeile: “zahl=255 (0xff)” mit beiden Platzhaltern
04 – Operatoren
Arithmetik
| Op | Bedeutung | Beispiel |
|---|---|---|
+ - * / |
plus minus mal geteilt | 7 / 2 → 3 bei int! |
% |
Rest (Modulo) | 7 % 2 → 1 |
++ |
um 1 erhöhen | i++ oder ++i |
-- |
um 1 verringern | i-- |
Integer-Division: 7 / 2 ist 3, nicht 3.5. Für Brüche double nutzen.
Vergleich (Ergebnis quasi „wahr/falsch“ als int: 1 oder 0)
| Op | Bedeutung |
|---|---|
== |
gleich |
!= |
ungleich |
< > <= >= |
kleiner / größer / … |
Falle: = ist Zuweisung, == ist Vergleich.
if (x = 0)   /* FALSCH: setzt x auf 0, Bedingung oft falsch */
if (x == 0)  /* richtig: prüft ob x 0 ist */
Logik
| Op | Bedeutung |
|---|---|
&& |
UND (beide wahr) |
|| |
ODER (mindestens eins wahr) |
! |
NICHT |
Kurzschluss: bei a && b wird b nicht ausgewertet, wenn a schon falsch ist.
Zuweisung kombiniert
x += 3;   /* x = x + 3 */
x *= 2;   /* x = x * 2 */
Bit-Operatoren (Ausblick → Lektion 19)
& | ^ ~ << >> – Masken, Flags, Nibbles. Hier nur merken: die gibt’s.
Priorität (vereinfacht, hoch → niedrig)
()++ -- !(unär)* / %+ -- Vergleiche
&&||= += …
Im Zweifel Klammern setzen:
if ((flags & MASK) != 0) { ... }Die Rechnung der Lektion mit den ints 7 und 2 ergibt bei der Division 3, nicht 3.5, und 7 % 2 ergibt den Rest 1. Dieselben Operatoren auf a gleich 17 und b gleich 5 liefern Summe 22, Differenz 12, Produkt 85, Quotient 3 und Rest 2. Der Vergleich a > b ist 1, a == b ist 0. Dann nimm x gleich 10. x += 5 schreibt 15 zurück nach x. Das Beispiel x += 3 würde aus 10 eine 13 machen, x *= 2 danach eine 26. Die Falle if (x = 0) schreibt 0 nach x und nimmt den Zweig meist nicht, weil 0 falsch ist. if (x == 0) prüft nur. Bei a gleich 17 und b gleich 5 ist a > 10 wahr und b < 10 wahr, also ist das Und 1. Wäre b gleich 10, würde der zweite Teil nicht mehr ausgewertet. Im Listing ist die Division ein idiv und der Rest ein zweites Register, nicht ein zweites Prozentzeichen.
Übung:
- TODO 1: Summe, Differenz, Produkt, ganzzahliger Quotient, Rest ausgeben
- TODO 2: boolesche Vergleiche als 0/1 ausgeben: printf(“a > b -> %d\n”, a > b); printf(“a == b -> %d\n”, a == b);
- TODO 3: int x = 10; dann x += 5; ausgeben
- TODO 4: Prüflogik (nur ausgeben, noch kein if nötig): (a > 10 && b < 10) als %d
05 – Verzweigungen: `if`, `else`, `switch`
if / else
if (bedingung) {
    /* wenn Bedingung „wahr“ (nicht 0) */
} else if (andere) {
    /* sonst, wenn andere wahr */
} else {
    /* sonst */
}
In C gilt: 0 = falsch, alles andere = wahr.
if (ptr) { ... }      /* true, wenn Pointer nicht NULL */
if (!ptr) { ... }     /* true, wenn Pointer NULL */
if (n != 0) { ... }
Geschweifte Klammern
Auch bei einer Zeile immer {} nutzen – verhindert Bugs:
if (ok)
    free(p);
    p = NULL;   /* läuft IMMER – Einrückung zählt in C nicht! */
switch (diskrete Werte)
switch (cmd) {
    case 1:
        /* ... */
        break;      /* ohne break: fall-through in nächsten case! */
    case 2:
        /* ... */
        break;
    default:
        /* alles andere */
        break;
}
Typisches Security-/Tool-Muster
if (argc != 2) {
    fprintf(stderr, "Usage: ...\n");
    return 1;
}
if (!load_file(path, &buf)) {
    fprintf(stderr, "fail: %s\n", strerror(errno));
    return 1;
}
Fehlerpfade früh verlassen („early return“) hält den Erfolgs-Pfad lesbar.
Folge score durch die Schwellen. Bei 95 ist score >= 90 wahr, der Zweig druckt sehr gut, und die Prüfung gegen 50 läuft nicht mehr. Bei 75 ist 90 zu hoch, 50 aber erreicht, also bestanden. Bei 40 scheitern beide Vergleiche, also nicht bestanden. Bei 0 scheitern sie ebenfalls, der else druckt nicht bestanden, und der zusätzliche Vergleich score == 0 druckt ungültig?. Die geschweiften Klammern halten das zweite printf im else. Ohne sie würde nur die erste Zeile am Zweig hängen und ungültig? immer laufen. Ein switch auf einen diskreten Status springt zum passenden Fall und braucht ein break, sonst fällt er in den nächsten Fall. Im Listing wird aus score >= 90 ein cmp gegen 90 und ein bedingter Sprung: wahr zum Text sehr gut, falsch weiter zum cmp gegen 50.
Übung: Lege eine Variable score an. Bei score >= 90 gib sehr gut aus, bei score >= 50 gib bestanden aus, sonst nicht bestanden. Im Extra-Fall score == 0 gib zusätzlich ungültig? aus. Teste die Schwellen mit 95, 75, 40 und 0, und setze bei jedem if geschweifte Klammern.
06 – Schleifen: `while`, `for`, `do while`
Wozu?
Etwas wiederholen: Bytes eines Puffers besuchen, Datei zeilenweise lesen, …
while
while (bedingung) {
    /* solange Bedingung wahr */
}
for – der Klassiker für Zähler
for (Initialisierung; Bedingung; Nachzieher) {
    Körper
}

for (int i = 0; i < n; ++i) {
    /* i = 0,1,2,...,n-1 */
}
Ablauf:
int i = 0einmal- prüfe
i < n– wenn falsch → Schleife Ende - Körper
++i- zurück zu 2
Array/Buffer durchlaufen (später extrem häufig)
for (size_t i = 0; i < size; ++i) {
    printf("%02x ", data[i]);
}
Genau so funktioniert print_preview / Hexdump.
break / continue
break– Schleife sofort verlassencontinue– Rest des Körpers überspringen, nächste Iteration
Endlosschleife (manchmal gewollt)
for (;;) { ... }
while (1) { ... }
Immer einen klaren break- oder return-Ausweg haben.
Off-by-one – der Klassiker
/* n Elemente: Indizes 0 .. n-1 */
for (int i = 0; i <= n; ++i)  /* FALSCH wenn i==n noch data[i] liest */
for (int i = 0; i < n; ++i)   /* richtig */
Die for-Schleife mit i von 0, solange i < 10, und ++i druckt zehn Zeilen: 0, dann 1, bis 9. i gleich 10 macht die Bedingung falsch, der Körper läuft nicht mehr. Die while-Summe startet bei 0 und addiert 1, dann 2, bis 100. Das Ergebnis ist 5050, nicht 4950, weil die 100 noch dazugehört, und nicht 5151, weil die 0 nicht in dieser Summe steckt. Die dritte Schleife druckt die geraden Zahlen 0, 2, 4 bis 20. Mit i += 2 sind das elf Werte. Mit i <= 20 und einer Prüfung i % 2 == 0 kommt dieselbe Folge heraus. Die Off-by-one-Falle i <= n bei n Elementen liest den Index n, der nicht existiert. break verlässt die Schleife sofort, continue springt zum Nachzieher. Im Listing ist das Ende ein cmp von i mit der Grenze und ein Sprung zurück an den Körper, solange die Grenze nicht erreicht ist.
Übung:
- TODO 1: for-Schleife: Zahlen 0 bis 9 jeweils in einer Zeile printf(“%d\n”, i)
- TODO 2: while-Schleife: Summe 1+2+…+100 in Variable sum, danach ausgeben
- TODO 3: for: nur gerade Zahlen von 0 bis 20 ausgeben (i += 2 oder if (i % 2 == 0))
07 – Arrays
Was ist ein Array?
Eine feste Reihe gleichartiger Elemente im Speicher, hintereinander.
int zahlen[5];           /* 5 ints, Werte noch Müll */
int zahlen[5] = {1,2,3,4,5};
int zahlen[]  = {1,2,3}; /* Compiler zählt: 3 Elemente */
Index
zahlen[0]  /* erstes Element – Index beginnt bei 0 */
zahlen[4]  /* letztes bei Größe 5 */
zahlen[5]  /* UNGÜLTIG – außerhalb, undefined behavior */
Speicherbild (vereinfacht):
Index:   0    1    2    3    4
Wert:   [1]  [2]  [3]  [4]  [5]
Adresse: a   a+4 a+8  ...     (wenn int 4 Byte)
Schleife über Array
int n = 5;
for (int i = 0; i < n; ++i) {
    printf("%d\n", zahlen[i]);
}
Array ist nicht dynamisch
Größe zur Compile-Zeit (oder VLA – hier meiden).
Wächst die Datenmenge zur Laufzeit → malloc (Lektion 16).
Array und Pointer (Vorgeschmack)
Der Name zahlen wird in den meisten Ausdrücken zu einem Pointer aufs erste Element:
zahlen == &zahlen[0] /* Adressen-mäßig „zeigt auf Anfang“ */Details: Lektion 12.
Mehrdimensional (kurz)
int matrix[2][3] = {{1,2,3},{4,5,6}};
matrix[1][2];  /* 6 */
Lege das Array bytes mit 10, 20, 30, 40, 50 an. Der Index 0 hält 10, der Index 4 hält 50. Eine Schleife von 0 bis unter 5 druckt genau diese fünf Zahlen. Die Summe ist 10+20+30+40+50 gleich 150. Danach setzt du den Index 1 auf 99. Die Reihe ist nun 10, 99, 30, 40, 50, und die Summe wird 229, weil 20 durch 99 ersetzt wurde und die anderen vier Werte bleiben. Der Index 5 liegt hinter dem letzten Element. Ein Zugriff dort ist kein sechstes Element, sondern ein Zugriff neben dem Array. Die Größe steht zur Übersetzungszeit fest. Der Name bytes wird in der Schleife zur Adresse des ersten Elements, der Index wird mit der Breite eines int multipliziert. Auf einem System mit vier Byte pro int liegt 99 an Index 1 vier Byte hinter der Basis, bei a+4, wie im Speicherbild. Index 2 läge bei a+8. Nicht ein Byte hinter der Basis.
Übung:
- TODO 1: int-Array “bytes” mit den Werten 10, 20, 30, 40, 50
- TODO 2: Mit for-Schleife alle Elemente ausgeben
- TODO 3: Summe aller Elemente berechnen und ausgeben
- TODO 4: Zweites Element (Index 1) auf 99 setzen und Array nochmal drucken
08 – `char` und C-Strings
char
Ein Byte, oft als Zeichen interpretiert (ASCII/UTF-8-Codeunit):
char c = 'A';     /* Zeichenliteral: einfache Anführungszeichen */
int code = c;     /* 65 */
'A' ≠ "A":
'A'= einchar-Wert"A"= String: zwei Bytes{'A', '\0'}im Speicher
C-String = char-Array mit Nullterminator
char name[] = "hi";
/* Speicher: 'h' 'i' '\0'   → 3 Bytes */
\0 (Bytewert 0) markiert das Ende. Ohne \0 liest %s wild weiter → Crash/Müll.
Wichtige Funktionen (string.h)
| Funktion | Zweck |
|---|---|
strlen(s) |
Länge ohne \0 |
strcpy(dst, src) |
kopieren (unsicher wenn dst zu klein!) |
strncpy / besser eigene sichere Kopie |
begrenztes Kopieren |
strcmp(a, b) |
0 wenn gleich |
strcat |
anhängen (auch puffergefährlich) |
In Security-Code: immer Längen kennen, strcpy misstrauen.
Text vs. Binär
| Text/String | Binärpuffer | |
|---|---|---|
| Ende | \0 |
eigene size_t length |
| Typ | char * |
uint8_t * + size |
| Nullbyte innen | bricht String ab | völlig normal |
Deshalb: Dateien mit fopen(..., "rb") und uint8_t * laden – nicht als String.
printf("%s", s)
Erwartet Pointer auf \0-terminierten String. Nie uninitialisierten oder binären Puffer mit %s drucken.
Das Array msg mit dem Text LowLevel belegt acht Zeichen plus das abschließende Nullbyte, also neun Byte. printf mit %s stoppt am Nullbyte und druckt LowLevel. strlen liefert 8, nicht 9, weil das Nullbyte nicht zur Länge zählt. msg[0] ist L. Als Zeichen gedruckt ist das L, als Zahl der Code 76. Das kleinere Beispiel hello mit hi liegt als 68, 69, 00 im Speicher: h, i und das Nullbyte. Eine Schleife bis einschließlich des Nullbytes druckt diese drei Hex-Werte. Eine Schleife nur bis strlen druckt 68 und 69 und verschluckt die 00. Ein char mit dem Zeichen A hat den Code 65. Einfache Anführungszeichen sind ein Zeichen, doppelte sind eine Zeichenkette mit Nullbyte. Im Listing ist strlen eine Schleife, die Bytes lädt, mit 0 vergleicht und den Zähler erhöht, bis das Nullbyte kommt.
Übung:
- TODO 1: char-Array msg mit “LowLevel” initialisieren
- TODO 2: msg mit %s ausgeben
- TODO 3: Länge mit strlen ausgeben (%zu)
- TODO 4: erstes Zeichen msg[0] als %c und als %d (ASCII-Code)
- TODO 5: char hello[] = “hi”; Bytes einzeln hex dump: for i=0..strlen(hello) einschließlich ‘\0’ -> %02x Erwartung u.a. 68 69 00 (‘h’ ‘i’ NUL)
09 – Funktionen
Warum?
- Code in benannte Stücke teilen
- Wiederverwenden
- Lesbarkeit (wie
load_file,print_preview)
Definition
/* Rückgabetyp  Name  (Parameterliste) */
int add(int a, int b) {
    return a + b;
}intvor dem Namen = was die Funktion zurückgibtvoid= gibt nichts zurück- Parameter: Kopien der Argumente (Call by Value) – außer Pointer!
Aufruf
int s = add(3, 4); /* s == 7 */Deklaration vs. Definition
int add(int a, int b);   /* Deklaration/Prototyp: „es gibt so eine Funktion“ */

int main(void) {
    add(1, 2);
}

int add(int a, int b) {  /* Definition: eigentlicher Code */
    return a + b;
}
Header-Dateien (.h) enthalten oft nur Deklarationen.
return
- beendet die Funktion sofort
- bei nicht-
void: liefert den Wert - in
main: Exit-Code an OS
Scope (Gültigkeitsbereich)
void f(void) {
    int x = 1;   /* lokal: nur in f sichtbar */
}
/* x hier unbekannt */
Mehrere Parameter, kein Rückgabewert
void greet(const char *name) {
    printf("hi %s\n", name);
}
square von 7 rechnet 7 mal 7 und gibt 49 zurück. Der Parameter x ist eine Kopie. Eine Zuweisung an x in square ändert das Argument in main nicht. print_twice mit dem Text ping ruft printf zweimal auf, also stehen zwei Zeilen ping untereinander, und der Rückgabetyp void liefert keinen Wert für ein weiteres printf. max2 von 3 und 9 vergleicht die Kopien. 3 ist nicht größer als 9, also nimmt die Funktion den Zweig, der b zurückgibt, und main druckt 9. Bei max2 von 9 und 3 wäre das Ergebnis 9 über den anderen Zweig. return beendet die Funktion an dieser Zeile. Ein return 0 in main ist der Exit-Code, ein return 49 in square ist der Wert, den der Aufrufer in eax erwartet. Eine Deklaration ohne Körper erlaubt den Aufruf weiter oben in der Datei, die Definition muss trotzdem genau einmal existieren.
Übung:
- TODO 1: Funktion square definieren: int square(int x) { return x * x; }
- TODO 2: Funktion print_twice: void print_twice(const char *s) { printf(“%s\n”, s); printf(“%s\n”, s); }
- TODO 3: Funktion max2: int max2(int a, int b) – größeren Wert zurückgeben
- TODO 4: square(7) ausgeben
- TODO 5: print_twice(“ping”)
- TODO 6: max2(3, 9) ausgeben
10 – Pointer Teil 1: Adressen, `&`, `*`
Kernidee
Eine Variable liegt irgendwo im Speicher unter einer Adresse. Ein Pointer ist eine Variable, die so eine Adresse speichert.
  int x = 42;          Speicher: [ 42 ] an Adresse 0x1000
  int *p = &x;         p hält 0x1000
  *p                   liest/schreibt den int an 0x1000 → 42
Syntax
int x = 42;
int *p;        /* p ist „Pointer auf int“ – noch uninitialisiert! */
p = &x;        /* & = Adress-Operator: „Adresse von x“ */
*p = 100;      /* * = Dereferenzierung: „Wert an Adresse p“ → x wird 100 */
int y = *p;    /* y = 100 */
Lesart von int *p
„*p ist ein int“ – also zeigt p auf einen int.
Leerzeichen: int* p, int *p, int * p sind gleich (Stilfrage).
Achtung bei: int *a, b; → nur a ist Pointer, b ist int!
NULL
#include <stddef.h>   /* oder stdio/stdlib */
int *p = NULL; /* zeigt absichtlich nirgends hin */NULList typisch((void*)0)– Adresse 0, „ungültig“.- Vor dem Dereferenzieren prüfen:
if (p != NULL) { ... *p ... } *NULL= Crash (Segfault / Access Violation)
Pointer ausgeben
printf("%p\n", (void *)p);   /* Adresse */
printf("%d\n", *p);          /* Wert hinter der Adresse */
Warum brauchen wir das?
- Funktionen sollen Aufrufer-Variablen ändern (Lektion 11).
- Dynamischer Speicher (
mallocliefert Pointer). - Arrays/Puffer durchlaufen.
- Structs und „Objekte“ ohne ständiges Kopieren großer Blöcke.
Stack-Bild (vereinfacht)
main:
  x = 42          @ 0x1000
  p = 0x1000      @ 0x1008
p und x sind verschiedene Variablen. p enthält die Adresse von x.
Im Bild der Lektion liegt x mit 42 an der Adresse 0x1000. p = &x speichert 0x1000 in p, nicht die 42. *p liest, was an 0x1000 steht, also wieder 42. Die Übung setzt danach *p = 7. Dieselbe Adresse wird beschrieben, deshalb ist x danach 7 und ein printf von x zeigt 7. p selbst bleibt 0x1000. Ein zweiter Zeiger q mit NULL zeigt absichtlich nirgends hin. Der Vergleich q == NULL ist wahr und druckt die Meldung. Ein *q an dieser Stelle würde die Adresse 0 benutzen und ist der Fehler, den die Prüfung verhindern soll. Ein uninitialisierter Zeiger ist kein NULL, sondern Müll, und darf genauso wenig dereferenziert werden. Im Listing ist & eine Adresse, die in ein Register geladen wird, und * ein mov aus der Klammer, deren Inhalt diese Adresse ist.
Übung:
- TODO 1: int-Pointer p anlegen und auf x zeigen lassen (p = &x)
- TODO 2: x, den Wert *p, und die Adresse p mit %p ausgeben printf(“x=%d *p=%d p=%p\n”, x, *p, (void *)p);
- TODO 3: Über den Pointer den Wert ändern: *p = 7; danach x ausgeben – muss 7 sein (gleiche Speicherstelle!)
- TODO 4: int *q = NULL; prüfen mit if (q == NULL) und Meldung drucken
11 – Pointer als Parameter (Out-Parameter)
Problem: Call by Value
void set_to_five(int n) {
    n = 5;   /* ändert nur die KOPIE */
}

int main(void) {
    int x = 1;
    set_to_five(x);
    /* x ist immer noch 1 */
}
Argumente werden kopiert. Die Funktion sieht nicht das Original.
Lösung: Adresse übergeben
void set_to_five(int *n) {
    if (n == NULL) {
        return;
    }
    *n = 5;   /* schreibe an die Adresse, die n speichert */
}

int main(void) {
    int x = 1;
    set_to_five(&x);  /* Adresse von x übergeben */
    /* x == 5 */
}
Out-Parameter
Viele C-Funktionen liefern Erfolg/Misserfolg als bool/int und schreiben
das eigentliche Ergebnis über einen Pointer:
bool load_file(const char *path, ByteBuffer *out) {
    /* ... bei Erfolg: out->data = ...; out->size = ...; return true; */
}
Aufruf:
ByteBuffer buffer;
if (!load_file("a.bin", &buffer)) {
    /* Fehler */
}
ByteBuffer *out= „Pointer auf ByteBuffer“&buffer= Adresse der lokalen Variable- in der Funktion:
out->feld(siehe Struct-Lektion) oder(*out).feld
Mehrere Ergebnisse
void divmod(int a, int b, int *q, int *r) {
    *q = a / b;
    *r = a % b;
}
const am Pointer
void print_buf(const uint8_t *data, size_t n);
/* data zeigt auf Bytes, die die Funktion NICHT ändern soll */| Schreibweise | Bedeutung |
|---|---|
const T *p |
*p nicht änderbar (Pointer wanderbar) |
T *const p |
Pointer selbst nicht auf woanders zeigbar |
const T *const p |
beides fix |
Merksatz
- Willst du die Variable des Aufrufers ändern → Pointer (
Type *) + Aufruf mit&var. - Nur lesen/kopieren des Werts → normaler Parameter.
Starte mit x gleich 1 und rufe set_to_five mit x auf, also mit der Kopie. Die Zuweisung n = 5 ändert nur die Kopie. Nach dem return ist x immer noch 1. Dieselbe Funktion mit int *n und dem Aufruf set_to_five(&x) schreibt über *n an die Adresse von x, und x wird 5. set_zero(&x) prüft den Zeiger, schreibt 0, und x ist danach 0. half von 20 und &result teilt 20 durch 2, schreibt 10 nach result und gibt true zurück. half von 20 und NULL gibt false zurück und schreibt nirgends hin, weil der NULL-Zweig vor der Zuweisung zurückkehrt. load_file folgt demselben Muster: der Pfad kommt herein, der Puffer geht über out hinaus, und ein Fehler lässt out leer. Im Listing liegt der Zeiger im ersten Argumentregister, und die Zuweisung ist ein mov an [rdi], nicht an das Register selbst.
Übung:
- TODO 1: void set_zero(int *n) – wenn n nicht NULL, *n = 0
- TODO 2: bool half(int value, int *out) wenn out == NULL -> false sonst *out = value / 2; return true;
- TODO 3: set_zero(&x); danach x ausgeben (0)
- TODO 4: if (half(20, &result)) printf(“%d\n”, result); Erwartung 10
- TODO 5: half(20, NULL) – sollte false liefern, Meldung ausgeben
12 – Pointer und Arrays
Array-Name ≈ Pointer aufs erste Element
int a[4] = {10, 20, 30, 40};
int *p = a;       /* gleich: int *p = &a[0]; */
Index vs. Pointer-Arithmetik
a[i]        /* Element i */
*(a + i)    /* dasselbe! */
p[i]        /* auch, wenn p auf Anfang zeigt */
*(p + i)
Der Compiler rechnet: Adresse + i * sizeof(Elementtyp).
p+0 → 10
p+1 → 20   (eine int-Breite weiter, nicht 1 Byte!)
Iteration mit Pointer
for (int *q = a; q < a + 4; ++q) {
    printf("%d\n", *q);
}
++q rückt um ein Element vor, nicht um 1 Byte (außer bei char/uint8_t).
Byte-Pointer (Low-Level)
uint8_t *bytes = ...;
bytes[i];           /* Byte i */
*(bytes + i);
Bei uint8_t ist sizeof == 1, also Pointer-Schritt = 1 Byte – ideal für Rohdaten.
Falle: Array ist kein „Pointer-Objekt“
int a[4];
/* a = p;   ILLEGAL – Array-Name ist nicht zuweisbar */
/* sizeof(a) = 4*sizeof(int), sizeof(p) = Größe eines Pointers (8 auf 64-bit) */
Funktion bekommt Array als Pointer
void print_all(const int *data, size_t n) {
    for (size_t i = 0; i < n; ++i) {
        printf("%d\n", data[i]);
    }
}
/* Aufruf: print_all(a, 4); */
Die Größe geht verloren – deshalb immer n/size mitgeben (wie ByteBuffer.size).
Das Array a mit 10, 20, 30, 40 hat vier ints. a[0] ist 10, a[2] ist 30. *(a + 2) ist dieselbe 30, weil der Compiler den Index 2 mit der Breite eines int multipliziert. Steht p auf a, ist p+1 nicht ein Byte weiter, sondern ein int weiter, und * (p+1) ist 20. Eine Schleife q von a bis unter a+4 druckt 10, dann 20, dann 30, dann 40 und stoppt, weil q die Grenze a+4 erreicht. sizeof(a) ist 16, wenn ein int vier Byte hat. sizeof(p) ist 8 auf einem 64-Bit-System, weil p nur die Adresse hält. Die Zuweisung a = p ist verboten. print_all bekommt nur die Adresse und die 4 als Länge. Ohne die 4 wüsste die Funktion nicht, dass nach 40 Schluss ist. Bei einem uint8_t-Puffer wäre der Schritt von ++q ein Byte, und *(data + 2) wäre das dritte Byte, identisch mit data[2].
Übung:
- TODO 1: Mit Index-Schleife alle Bytes als %02x ausgeben
- TODO 2: unsigned char *p = data; Mit p[i] dieselben Bytes nochmal ausgeben
- TODO 3: Zeige, dass *(data + 2) == data[2] (beide ausgeben)
- TODO 4: Pointer-Walk: for (unsigned char *q = data; q < data + 6; ++q) printf(“%02x “, *q);
13 – `struct` und `typedef`
struct = mehrere Felder unter einem Dach
struct Punkt {
    int x;
    int y;
};

struct Punkt p;
p.x = 3;
p.y = 4;
Der Punkt . greift auf ein Feld zu, wenn du das Struct selbst hast.
Pointer auf Struct: ->
struct Punkt *ptr = &p;
ptr->x = 10; /* gleichbedeutend: (*ptr).x = 10 */| Situation | Zugriff |
|---|---|
Variable p |
p.x |
Pointer ptr |
ptr->x |
In load_file(..., ByteBuffer *out) deshalb: out->data, out->size.
typedef = Typalias
typedef struct {
    uint8_t *data;
    size_t size;
} ByteBuffer;
Danach ist ByteBuffer ein neuer Typname (kein struct … mehr nötig).
Gleichwertig länger:
struct ByteBuffer {
    uint8_t *data;
    size_t size;
};
typedef struct ByteBuffer ByteBuffer;
Initialisierung
ByteBuffer buf = { NULL, 0 };
ByteBuffer buf = { .data = NULL, .size = 0 };  /* designated, C99 */
Structs kopieren
ByteBuffer a = buf; /* kopiert die FELDER (Pointer-Wert + size), NICHT den Heap-Inhalt! */Beide zeigen danach auf denselben data-Puffer → Ownership-Vorsicht (Lektion 21).
Warum in OffSec-Tools?
Headers (ELF, PE, Netzwerkpakete) sind natürliche Structs.
ByteBuffer bündelt „Pointer + Länge“ – ohne Länge ist ein Rohpuffer nutzlos.
Ein Punkt mit den Feldern x und y legt x an den Offset 0 und y, bei einem int von vier Byte, an den Offset 4. ptr = &p und ptr->x = 10 schreiben 10 an den Anfang des Objekts. (*ptr).x ist dieselbe Stelle. Der ByteBuffer aus der Übung hat data und size. byte_buffer_init mit einem gültigen Zeiger setzt data auf NULL und size auf 0. byte_buffer_set_size mit 16 schreibt 16 nach size und lässt data NULL, weil diese Übung den Puffer noch nicht anlegt. Ein Zeiger p = &buf sieht dasselbe Objekt: p->size ist ebenfalls 16, nicht eine Kopie der 16. init mit NULL kehrt zurück, ohne zu schreiben. Im Listing ist ptr->x ein Zugriff bei [rdi], ptr->y ein Zugriff bei [rdi+4], und size ein Feld weiter hinten, sobald ein Zeiger davor Platz braucht. Der Typname Punkt steht im Binary nicht mehr, die Abstände bleiben.
Übung:
- TODO 1: typedef struct { uint8_t *data; size_t size; } ByteBuffer; (data vorerst ungenutzt – wir setzen nur Größe und einen Dummy)
- TODO 2: void byte_buffer_init(ByteBuffer *b) wenn b == NULL return; b->data = NULL; b->size = 0;
- TODO 3: void byte_buffer_set_size(ByteBuffer *b, size_t n) wenn b != NULL: b->size = n;
- TODO 4: init, size auf 16 setzen, mit printf size ausgeben (%zu)
- TODO 5: ByteBuffer *p = &buf; p->size ausgeben (muss gleich sein)
14 – `stdint.h`: `uint8_t`, `uint32_t`, …
Problem
int / long haben plattformabhängige Größen. Für Binaries brauchst du:
- genau 1 Byte
- genau 4 Byte little-endian
- usw.
Feste Breiten
#include <stdint.h>

int8_t    /* 1 Byte, signed  -128..127 */
uint8_t   /* 1 Byte, unsigned 0..255   ← „ein Byte“ */
int16_t / uint16_t
int32_t / uint32_t
int64_t / uint64_t
uint8_t ist der Standard-Typ für Rohdaten, Opcodes, File-Buffer.
Literale
uint8_t b = 0xFF;
uint32_t magic = 0x7F454C46;  /* oft ELF-ähnlich */
0x = Hexadezimal.
Ausgabe portabel (inttypes.h)
#include <inttypes.h>
#include <stdio.h>

uint8_t b = 0xab;
uint32_t w = 0x0a1b2c3d;

printf("%02" PRIx8 "\n", b);      /* hex byte */
printf("%08" PRIx32 "\n", w);     /* hex 32-bit */
printf("%" PRIu32 "\n", w);       /* dezimal */
PRIx8 ist ein Makro, das zum richtigen %… expandiert.
Warum nicht unsigned char?
Oft gleich groß und kompatibel – aber uint8_t signalisiert klar „genau 8 Bit Zahl/Byte“,
nicht „Zeichen“. In Security-Code ist uint8_t * die übliche Lesart für Binärpuffer.
uint8_t a mit 10 und uint8_t b mit 255 sind genau ein Byte, unabhängig davon, wie breit int auf dem System ist. Mit dem Format für acht Bit wird a als 0a gedruckt und b als ff. Das Array buf mit de, ad, be, ef druckt in der Schleife de ad be ef und dann eine neue Zeile. Es sind vier Bytes, nicht ein int, der diese Ziffern irgendwie enthält. sizeof(uint8_t) ist 1, sizeof(uint32_t) ist 4. Ein uint32_t kann die vier Bytes aufnehmen, ein uint8_t nicht, ohne den Wert zu schneiden. 255 passt noch in ein Byte, 256 nicht. Darum ist uint8_t der Typ für Opcodes und Dateipuffer, und unsigned char ist nur dann dasselbe, wenn du wirklich ein Byte meinst und kein Zeichen. Im Listing ist ein Ladebefehl auf so ein Feld ein mov von einem Byte, nicht von einem vollen eax, solange der Compiler die Breite ernst nimmt.
Übung:
- TODO 1: uint8_t a = 10; uint8_t b = 255;
- TODO 2: beide mit %02x bzw. besser “%02” PRIx8 ausgeben
- TODO 3: uint8_t buf[4] = { 0xde, 0xad, 0xbe, 0xef }; Schleife: jedes Byte hex mit Leerzeichen, dann newline
- TODO 4: sizeof(uint8_t), sizeof(uint32_t) ausgeben (%zu) – Erwartung 1 und 4
15 – `size_t`
Was ist das?
size_t ist ein unsigned Integer-Typ, groß genug für:
- Objektgrößen (
sizeof) - Array-Indizes
- Längen von Puffern und Strings (
strlengibtsize_tzurück)
#include <stddef.h>   /* size_t, NULL */
/* kommt auch über stdio.h / stdlib.h */
Warum nicht einfach int?
intkann negativ sein – Längen sind nie negativ.- Auf 64-bit-Systemen kann
size_t64 Bit sein,intoft nur 32. - Standard-Bibliothek nutzt überall
size_t→ Typ-Match vermeidet Warnungen.
Typisches Muster
typedef struct {
    uint8_t *data;
    size_t size;     /* Anzahl gültiger Bytes */
} ByteBuffer;

for (size_t i = 0; i < buffer.size; ++i) {
    use(buffer.data[i]);
}
Ausgabe
printf("%zu\n", size);                 /* z = size_t */
printf("%lu\n", (unsigned long)size);  /* Fallback älter */
Fallen
Vergleich mit signed
int n = -1;
size_t s = 10;
if (n < s)  /* n wird zu unsigned „umgedeutet“ → riesige Zahl, Vergleich oft falsch */
Lieber beide Seiten size_t, oder klar casten und vorher negativ prüfen.
ftell → size_t
long file_size = ftell(fp);
if (file_size < 0) { error; }
size_t size = (size_t)file_size;  /* erst nach Negativ-Check */
Genau das verlangt OffSec-Übung 01.
strlen von hi liefert 2. Das Nullbyte dahinter zählt nicht mit, und %zu druckt diese 2 als size_t. sizeof(int) druckt die Breite des Typs, auf einem üblichen Desktop 4. Das Array raw mit acht uint8_t hat sizeof 8. Die Schleife i von 0, solange i < 8, druckt die Indizes 0 bis 7. i gleich 8 beendet sie. Die Werte in raw sind egal, weil die Übung nur die Indizes zeigt. long maybe gleich 100 ist nicht negativ, der Vergleich maybe >= 0 ist wahr, und der Cast nach size_t ergibt 100. Ein maybe von -1 würde denselben Vergleich verlieren und dürfte nicht in eine Länge umgewandelt werden, weil size_t keine negativen Längen kennt. Eine Schleife über buffer.size mit size_t i läuft von 0 bis unter die Länge. Im Listing ist der Vergleich der Länge oft ein vorzeichenloser Sprung, passend zu size_t, nicht ein jg für ein int, das negativ werden kann.
Übung:
- TODO 1: size_t len = strlen(s); ausgeben mit %zu
- TODO 2: size_t bytes_int = sizeof(int); ausgeben
- TODO 3: Array uint8_t raw[8]; size_t n = sizeof(raw); Schleife i = 0; i < n; ++i → Index und Platzhalter (Werte von raw nicht nutzen – nur Indizes 0..7 drucken)
- TODO 4: long maybe = 100; wenn maybe >= 0, in size_t safe umwandeln und drucken
16 – `malloc` und `free` (Heap)
Zwei Speicherwelten
| Stack | Heap | |
|---|---|---|
| Beispiel | int x; char buf[64]; |
malloc(64) |
| Lebensdauer | bis Funktionsende | bis free |
| Größe | oft fest / begrenzt | zur Laufzeit wählbar |
| Freigabe | automatisch | du musst freeen |
malloc
#include <stdlib.h>

void *malloc(size_t n); /* n Bytes, Inhalt UNINITIALISIERT */- Rückgabe: Pointer auf den Block, oder
NULLwenn es scheitert. void *= „Pointer ohne Typ“ – du castest implizit:
uint8_t *data = malloc(size);
if (data == NULL) {
    /* Out of memory */
    return false;
}
free
free(data);
data = NULL; /* gute Angewohnheit: dangling pointer vermeiden */- Jeder erfolgreiche
mallocbraucht genau einfree. free(NULL)ist erlaubt (no-op).- Doppelt
free= undefined behavior (Crash/Corruption).
calloc / realloc (kurz)
calloc(count, size);  /* wie malloc, aber mit 0 gefüllt */
realloc(ptr, new_n);  /* Block vergrößern/verkleinern (kann umziehen!) */
Leere Allokation
malloc(0) ist implementierungsdefiniert. Für „0 Bytes“ oft:
if (size == 0) {
    out->data = NULL;
    out->size = 0;
} else {
    out->data = malloc(size);
    ...
}
Fehlerpfade
uint8_t *data = malloc(size);
if (data == NULL) {
    fclose(fp);       /* andere Ressourcen trotzdem freigeben */
    return false;
}
if (fread(...) != size) {
    free(data);       /* bei Fehler den schon allokierten Block freigeben */
    fclose(fp);
    return false;
}
Mentalmodell für Übung 01
load_file:
  malloc(size)  →  data
  fread in data
  out->data = data   (Ownership geht an Aufrufer)
  return true

main:
  ...
  byte_buffer_destroy → free(out->data)
malloc von n gleich 4 liefert entweder NULL oder eine Adresse von vier Byte. Bei NULL druckst du die Fehlermeldung und kehrst mit return 1 zurück, ohne free, weil es keinen Block gibt. Bei Erfolg schreibst du in jedes Byte 0x41. Die vier Stellen sind danach 41 41 41 41 in Hex und AAAA, wenn du sie als Zeichen druckst. free gibt genau diesen Block zurück, und data = NULL sorgt dafür, dass ein zweites free nicht denselben Zeiger noch einmal sieht. malloc von 0 behandelst du in dieser Übung als data gleich NULL, ohne einen Block anzulegen. Ein vergessenes free bei n gleich 4 lässt die vier Bytes bis zum Prozessende liegen. Ein free und danach ein Lesen von data[0] benutzt einen Zeiger, der nicht mehr gilt. Im Listing ist malloc ein call, die Schleife schreibt das Byte 0x41 an [Zeiger+i], und free ist ein zweiter call mit derselben Adresse.
Übung:
- TODO 1: uint8_t *data = malloc(n); wenn NULL: Fehlermeldung, return 1
- TODO 2: Alle Bytes auf 0x41 (‘A’) setzen – Schleife oder memset(data, 0x41, n)
- TODO 3: Hex ausgeben (%02x), dann als kurze „ASCII“-Zeile (%c)
- TODO 4: free(data); data = NULL;
- TODO 5 (optional): malloc(0)-Diskussion – hier size 0: data = NULL; kein malloc
17 – Dateien: `fopen`, `fseek`, `ftell`, `fread`, `fclose`
Überblick
#include <stdio.h>

FILE *fp = fopen(path, mode);
/* lesen/schreiben */
fclose(fp);
FILE * ist ein Handle auf einen Stream (undurchsichtige Struct).
Modi (Auszug)
| Mode | Bedeutung |
|---|---|
"r" |
lesen, Text |
"rb" |
lesen, binär ← für EXE/ELF/Dumps |
"w" / "wb" |
schreiben (überschreibt/neu) |
"a" |
anhängen |
"r+b" |
lesen+schreiben, binär |
Unter Windows wandelt Textmodus Zeilenenden um – Binärdaten kaputt.
Immer "rb" für OffSec/Binary-Tools.
Größe einer Datei
if (fseek(fp, 0, SEEK_END) != 0) { /* Fehler */ }
long file_size = ftell(fp);
if (file_size < 0) { /* Fehler */ }
if (fseek(fp, 0, SEEK_SET) != 0) { /* Fehler */ } /* zurück an Anfang */| Symbol | Bedeutung |
|---|---|
SEEK_SET |
ab Dateianfang |
SEEK_CUR |
ab aktueller Position |
SEEK_END |
ab Dateiende |
fseek/ftell mit long – für riesige Dateien gibt es fseeko/ftello (hier reicht long).
fread
size_t fread(void *ptr, size_t elem_size, size_t count, FILE *fp);- Liest bis zu
countElemente àelem_sizeBytes nachptr. - Rückgabe: Anzahl komplett gelesener Elemente.
Für Bytes:
size_t got = fread(data, 1, size, fp);
if (got != size) {
    /* zu kurz oder Fehler – ferror(fp) / feof(fp) */
}
fclose auf jedem Pfad
FILE *fp = fopen(...);
if (!fp) return false;

/* ... wenn irgendwo Fehler: */
fclose(fp);
return false;

/* Erfolg: */
fclose(fp);
return true;
Kleines volles Muster (ohne Struct)
FILE *fp = fopen(path, "rb");
if (fp == NULL) return false;
fseek(fp, 0, SEEK_END);
long sz = ftell(fp);
fseek(fp, 0, SEEK_SET);
/* malloc, fread, fclose, … */
Ein Aufruf ohne Dateinamen hat argc ungleich 2. Die Usage-Zeile geht nach stderr und main endet mit 1, ohne fopen. Mit einem gültigen Pfad öffnet fopen im Modus rb. Eine fehlende Datei ergibt NULL, perror nennt den Grund, und es gibt nichts zu schließen. Eine vorhandene Datei mit den vier Bytes 41 42 43 44 lässt fseek ans Ende, ftell gleich 4 und den zweiten fseek zurück an den Anfang laufen. size ist die size_t 4, malloc holt vier Byte, fread muss 4 zurückgeben. Die Vorschau der ersten min(16, 4) Bytes ist 41 42 43 44. Danach free und fclose. Ist die Datei leer, ist ftell 0, data bleibt NULL, und fread entfällt. Ein ftell kleiner als 0 ist ein Fehler, kein Cast auf eine riesige size_t. Im Listing ist jede dieser Prüfungen ein cmp des Rückgabewerts und ein Sprung in den Fehlerpfad.
Übung:
- TODO 1: wenn argc != 2: Usage auf stderr, return 1 fprintf(stderr, “Usage: %s
\n”, argv[0]); - TODO 2: fopen path “rb”, bei NULL perror(“fopen”) oder fprintf + return 1
- TODO 3: Dateigröße per fseek/ftell/fseek, als size_t speichern (Negativ-Check auf ftell!)
- TODO 4: wenn size > 0: malloc, fread komplett, bei Fehler free+fclose+return 1 wenn size == 0: data = NULL ok
- TODO 5: Größe und erste min(16, size) Bytes hex ausgeben
- TODO 6: free + fclose
18 – `errno` und Fehlerbehandlung
Idee
Viele C-Bibliotheksfunktionen signalisieren Fehler so:
- Rückgabe:
NULL,-1,0,false, … - globaler Code:
errnoerklärt warum
#include <errno.h>
#include <string.h>  /* strerror */
#include <stdio.h>   /* perror */

FILE *fp = fopen(path, "rb");
if (fp == NULL) {
    perror("fopen");  /* druckt "fopen: No such file or directory" */
    /* oder: fprintf(stderr, "%s\n", strerror(errno)); */
    return 1;
}
errno selbst setzen
Wenn deine Funktion scheitert:
#include <errno.h>

if (path == NULL || out == NULL) {
    errno = EINVAL;   /* invalid argument */
    return false;
}
if (data == NULL) {
    errno = ENOMEM;   /* out of memory */
    return false;
}
Häufige Konstanten:
| Makro | Bedeutung |
|---|---|
EINVAL |
ungültiges Argument |
ENOMEM |
kein Speicher |
ENOENT |
Datei/Pfad nicht gefunden (oft von fopen) |
EIO |
I/O-Fehler |
ENOSYS |
„not implemented“ (Stubs) |
Regeln
errnonur auswerten, wenn die Funktion Fehler signalisiert hat.- Erfolgreiche Calls dürfen
errnounverändert lassen oder „Müll“ hinterlassen – nicht blind lesen. - Manche Funktionen setzen
errnonicht → eigener Code + Log.
bool als Erfolg
#include <stdbool.h>

bool do_stuff(...) {
    if (fail) {
        errno = ...;
        return false;
    }
    return true;
}

if (!do_stuff(...)) {
    fprintf(stderr, "fail: %s\n", strerror(errno));
}
Genau das Muster von load_file in der OffSec-Übung.
EXIT_SUCCESS / EXIT_FAILURE
#include <stdlib.h>
return EXIT_SUCCESS;  /* 0 */
return EXIT_FAILURE;  /* nicht 0 */
parse_u8 mit NULL als Text oder NULL als Ziel setzt errno auf EINVAL und gibt false zurück, ohne zu schreiben. Der Text 255 hat ein Ende direkt am Nullbyte, der Wert 255 passt in ein Byte, also schreibt die Funktion 255 nach out und gibt true zurück. main druckt dann 255 und ff. Der Text 256 ist eine Zahl, aber größer als 255, also errno ERANGE und false, out bleibt unverändert. Der Text 12x parst 12 und lässt end auf dem x stehen. Weil das nicht das Nullbyte ist, gilt EINVAL, nicht der Wert 12. Die leere Zeichenkette scheitert genauso. Ein fopen, das NULL liefert, lässt errno auf dem Grund stehen, und strerror oder perror druckt ihn. Wer errno vor dem nächsten Aufruf nicht auswertet, verliert den Grund. Im Listing ist der frühe return ein Sprung hinter die Zuweisung an out, und der Erfolg ist der einzige Weg, der das Byte schreibt.
Übung:
- TODO 1: bool parse_u8(const char *s, uint8_t *out) - wenn s == NULL oder out == NULL: errno=EINVAL; return false - wenn s leer oder keine Zahl: errno=EINVAL; return false - Zahl mit strtoul(s, &end, 0) parsen - wenn *end != ‘\0’ (Müll danach): EINVAL - wenn Wert > 255: errno=ERANGE; return false - sonst *out = (uint8_t)wert; return true Tipp: char *end = NULL; unsigned long v = strtoul(s, &end, 0); #include <stdlib.h> ist schon da
- TODO 2: parse_u8(argv[1], &value) bei false: fprintf stderr mit strerror(errno), EXIT_FAILURE bei true: Wert dezimal und hex ausgeben
19 – Bits, Hex, Masken
Hexadezimal
| Dez | Hex | Binär (nibble) |
|---|---|---|
| 0 | 0 | 0000 |
| 10 | A | 1010 |
| 15 | F | 1111 |
| 255 | FF | 1111_1111 |
Ein Byte = 8 Bit = zwei Hex-Ziffern (0x3F).
uint8_t b = 0x3F;Operatoren
| Op | Name | Beispiel (bitweise) |
|---|---|---|
& |
AND | Flags testen: if (flags & 0x01) |
| |
OR | Flag setzen: flags |= 0x01 |
^ |
XOR | umschalten / Differenz |
~ |
NOT | Bits invertieren |
<< |
Shift left | 1u << 3 → Bit 3 |
>> |
Shift right | herausschieben |
Nicht verwechseln: && || sind logisch (wahr/falsch), & | sind bitweise.
Nibble / Bytes zusammensetzen
/* High-Nibble und Low-Nibble */
uint8_t hi = (byte >> 4) & 0x0F;
uint8_t lo = byte & 0x0F;

/* Little-endian uint32 aus 4 Bytes */
uint32_t v = (uint32_t)b0
           | ((uint32_t)b1 << 8)
           | ((uint32_t)b2 << 16)
           | ((uint32_t)b3 << 24);
Das brauchst du in OffSec-Übung 02/03 (Endian, uint32 aus Bytes).
Masken
#define FLAG_READ  0x01
#define FLAG_WRITE 0x02

flags |= FLAG_READ;           /* setzen */
flags &= (uint8_t)~FLAG_READ; /* löschen */
if (flags & FLAG_WRITE) { }   /* testen */
Das Byte 0x3F hat das hohe Nibble 3 und das niedrige Nibble F. (0x3F >> 4) & 0x0F ist 3, 0x3F & 0x0F ist 15, also F. flags startet bei 0. Bit 0 setzen macht 0x01, Bit 2 zusätzlich setzen macht 0x05. Der Test flags & (1u << 2) ist ungleich 0, der Zweig läuft. Ein Test auf Bit 1 an 0x05 ist 0, der Zweig läuft nicht. Die vier Bytes 0x0d, 0x0c, 0x0b, 0x0a in Little Endian werden zu 0x0a0b0c0d: das erste Byte ist der niedrigste Teil, das letzte der höchste. Vertauscht du die Reihenfolge beim Schieben, kommt 0x0d0c0b0a heraus, eine andere Zahl aus denselben vier Stellen. FLAG_READ als 0x01 und FLAG_WRITE als 0x02 lassen sich setzen, löschen und testen, ohne die anderen Bits zu verschieben. Im Listing sind das and, or und ein Schieben um die Bitnummer.
Übung:
- TODO 1: byte hex und binär-nah ausgeben: High nibble = (byte >> 4) & 0x0F Low nibble = byte & 0x0F
- TODO 2: uint8_t flags = 0; Setze Bit 0 und Bit 2 (flags |= (1u << 0); flags |= (1u << 2)); Teste Bit 2 mit if (flags & (1u << 2))
- TODO 3: Aus Bytes 0x0d, 0x0c, 0x0b, 0x0a little-endian uint32 bauen Erwartung: 0x0a0b0c0d printf(“%08” PRIx32 “\n”, value);
20 – Casts und Rohbytes
Cast = „behandle diesen Wert als anderen Typ“
long file_size = 100;
size_t size = (size_t)file_size;   /* expliziter Cast */
Ohne Cast macht der Compiler manchmal implizite Umwandlungen (Warnungen beachten).
Integer-Casts
uint32_t x = 300;
uint8_t b = (uint8_t)x;   /* 300 % 256 = 44 – obere Bits weg! */
Bewusst kürzen = ok wenn gewollt; unbewusst = Bug.
Pointer-Casts (gefährlich, aber in RE üblich)
uint8_t *raw = buffer;
uint32_t *as_words = (uint32_t *)raw;  /* Alignment! */
Probleme:
- Alignment: Manche CPUs wollen
uint32_tan 4-Byte-Grenzen. - Strict aliasing / Undefined Behavior in aggressiv optimiertem C.
Sicherer für unaligned Rohdaten: Byteweise zusammenbauen (Lektion 19) oder memcpy:
uint32_t value;
memcpy(&value, raw + offset, sizeof(value));
Struct über Bytes (Ausblick OffSec 05)
#pragma pack(push, 1)
typedef struct {
    uint32_t magic;
    uint16_t version;
} Header;
#pragma pack(pop)

/* Nach dem Laden: */
Header h;
memcpy(&h, data, sizeof(h));
Oder Feld für Feld aus Little-Endian-Bytes lesen.
(void)var
(void)path; /* „absichtlich unbenutzt“ – unterdrückt Compiler-Warnung */Im Stub von load_file siehst du das, bis du path wirklich nutzt.
const-Cast (meist meiden)
char *p = (char *)const_string; /* wirft const weg – gefährlich */long file_size gleich 100 wird mit einem expliziten Cast zur size_t 100. Der Wert bleibt 100, der Typ wird eine Länge. uint32_t x gleich 300 passt nicht in ein Byte. Der Cast auf uint8_t behält 44, weil 300 minus 256 gleich 44 ist, die oberen Bits fallen weg. long negative gleich -1 besteht den Vergleich negative >= 0 nicht. Der else-Zweig druckt, dass kein Cast stattfindet. Ein blinder Cast von -1 auf size_t wäre eine sehr große Länge, nicht minus eins. Die vier Bytes 78 56 34 12 ergeben über memcpy auf einem Little-Endian-System den uint32_t 0x12345678. Dieselbe Zahl byteweise zusammengesetzt, niedrigstes Byte zuerst, muss denselben Wert liefern. Ein Cast des Bytezeigers auf uint32_t * liest vier Byte auf einmal und setzt voraus, dass die Adresse ausgerichtet ist. Im Listing ist der schmale Cast ein movzx oder ein Abschneiden auf al, nicht ein zweites Register mit den verlorenen Bits.
Übung:
- TODO 1: long negative = -1; NICHT blind nach size_t casten ohne Check. if (negative >= 0) { size_t s = (size_t)negative; … } else printf(“negativ, kein Cast\n”);
- TODO 2: uint8_t raw[4] = { 0x78, 0x56, 0x34, 0x12 }; uint32_t value; memcpy(&value, raw, 4); Auf little-endian Windows: Erwartung 0x12345678 printf(“%08” PRIx32 “\n”, value);
- TODO 3: Dieselbe Zahl byteweise bauen wie in 19 (ohne memcpy) und vergleichen
21 – `const` und Ownership
const am Datenzeiger
void print_preview(const uint8_t *data, size_t size);Die Funktion darf die Bytes nicht ändern. Aufrufer behält Schreibrechte.
const char *path /* Stringinhalt nicht über path[] ändern */Ownership = „wer ist für free zuständig?“
Regel, die du dir fest einprägst:
Wer allokiert, dokumentiert, wer freigibt.
Beispiel OffSec-Übung 01
load_file:
  - malloc für data
  - bei Erfolg: Ownership geht an den Aufrufer (out->data)
  - bei Fehler: selbst free, out bleibt leer

main:
  - bei Erfolg: byte_buffer_destroy(&buffer) → free
void byte_buffer_destroy(ByteBuffer *buffer) {
if (buffer == NULL) return;
free(buffer->data);
buffer->data = NULL;
buffer->size = 0;
}Nach destroy ist der Struct in einem sicheren Null-Zustand (nochmal destroy = ok).
Doppel-Ownership vermeiden
ByteBuffer a = b;   /* kopiert den POINTER – beide „besitzen“ denselben Block */
free(a.data);
free(b.data);       /* BOOM double free */
Wenn Kopie des Inhalts nötig: neuer malloc + memcpy („deep copy“).
const und Ownership
const uint8_t * bedeutet meist: „ich borge nur, free nicht“.
Wer malloc zurückgibt als uint8_t * (nicht const): Aufrufer owned.
Checkliste bei jeder Pointer-API
- Darf der Pointer
NULLsein? - Wer allokiert?
- Wer freigibt?
- Was passiert bei Fehler mit schon allokierten Teilen?
- Ist die Länge immer bekannt (
size)?
byte_buffer_create mit size 4 und einem gültigen out legt vier Byte an und setzt size auf 4. Du schreibst de, ad, be, ef hinein. print_preview bekommt einen const-Zeiger, druckt die Größe 4 und die vier Bytes und darf data[0] nicht verändern. destroy gibt den Block frei, setzt data auf NULL und size auf 0. Ein zweites destroy auf demselben Objekt sieht NULL und tut nichts. create mit NULL als out gibt false zurück und legt nichts an. create mit size 0 gibt true zurück, data bleibt NULL, size bleibt 0, und preview druckt die Größe 0 ohne Bytes. Der Aufrufer besitzt den Block nur nach true. Bei einem malloc-Fehler gibt create false zurück und lässt out leer, weil die Funktion den Fehlblock selbst nicht an den Aufrufer übergibt. Im Listing ist der const-Parameter nur eine Vereinbarung des Quelltexts. Das Schreiben verhindert die Typprüfung, bevor überhaupt ein mov an den Puffer entsteht.
Übung:
- TODO 1: void byte_buffer_destroy(ByteBuffer *b) free data, data=NULL, size=0; NULL-safe
- TODO 2: bool byte_buffer_create(ByteBuffer *out, size_t size) - out NULL -> false - out initial auf NULL/0 - size==0: true, data bleibt NULL - sonst malloc; bei Fail false - optional: memset 0 - out->data/size setzen, true
- TODO 3: void print_preview(const ByteBuffer *b) const: darf Inhalt nicht ändern Größe + bis 8 Bytes hex
- TODO 4: create mit size 4, bytes setzen z.B. de ad be ef, preview, destroy
- TODO 5: create(NULL, 10) und create ok mit 0 testen
22 – Mini-Hexdump (alles zusammen)
Ziel
Ein kleines Programm, das eine Datei lädt und hex dump’t – mit den Bausteinen:
| Baustein | Lektion |
|---|---|
main(argc, argv) |
17 |
ByteBuffer struct |
13 |
uint8_t / size_t |
14, 15 |
malloc / free |
16 |
fopen "rb" / fread |
17 |
Fehler + errno |
18 |
| Out-Parameter | 11 |
| Ownership destroy | 21 |
%02x Preview |
03, 19 |
Das ist dieselbe Architektur wie 01_datei_in_buffer.c – nur von dir gebaut.
Empfohlene Struktur in der Übung
typedef struct {
    uint8_t *data;
    size_t size;
} ByteBuffer;

void byte_buffer_destroy(ByteBuffer *b);
bool load_file(const char *path, ByteBuffer *out);
void print_preview(const ByteBuffer *b, size_t max_bytes);

int main(int argc, char *argv[]) {
    /* argc check → load_file → preview → destroy */
}
Akzeptanzkriterien
programm.exe fehlend→ Usage, Exit ≠ 0- existierende Datei →
size=…und Hex der ersten Bytes - leere Datei →
size=0, kein Crash - kein Leak: destroy immer nach erfolgreichem load
- du kannst jede Zeile erklären
Danach
Öffne 00_Grundlagen/C_Uebungen/01_datei_in_buffer.c und implementiere nur noch die TODOs in load_file – der Rest ist dir bekannt.
Theorie + weitere OffSec-Übungen: 00_Grundlagen/C_Übungen.txt.
Der Mini-Hexdump setzt die vorigen Stücke an einer Datei zusammen. load_file mit einem NULL-Pfad setzt EINVAL und gibt false zurück, ohne einen Puffer zu hinterlassen. Eine Datei mit den Bytes de ad be ef hat die Länge 4. fopen im Modus rb, die Größe über fseek und ftell, malloc von genau 4, ein fread das 4 liefert, fclose, und erst dann stehen data und size im out. print_preview druckt die Größe und höchstens max_bytes der ersten Bytes, hier de ad be ef. destroy gibt frei und nullt die Felder. Eine leere Datei hat die Länge 0, data bleibt NULL, der Erfolg ist trotzdem gültig, und die Vorschau zeigt die Größe 0. Ein kurzer Read, der 3 statt 4 liefert, gibt den Block frei, schließt die Datei und gibt false zurück. Der Aufrufer sieht keinen halben Puffer. Im Listing erkennst du die Kette an den calls und an dem einen Zweig, der out erst nach dem vollständigen Read beschreibt.
Übung:
- TODO: destroy – free + nullen, NULL-safe
- TODO: load_file – vollständige Logik aus den Lektionen 11,16,17,18,21 Schritte: 1 path/out NULL -> errno EINVAL, false 2 out nullen 3 fopen rb 4 fseek/ftell/fseek, size_t nach Check 5 malloc (size 0 -> data NULL) 6 fread vollständig 7 fclose immer; free bei Fehler 8 nur bei Erfolg out befüllen
- TODO: erste max_bytes als hex, plus size
C für Cybersecurity lernen
Datei vollständig in einen Byte-Buffer laden
Eine Datei ist für den Rechner nur eine Folge von Bytes. Diese Übung lädt sie vollständig in einen Puffer, den du besitzt: Zeiger und Länge zusammen, Fehler von fopen, fseek und fread geprüft, und free genau einmal. Später liest du so Header, Sektionen und Strings, statt einzelne Bytes mit dem Hex-Editor zu erraten.
Der Puffer hat zwei Felder, data und size. size ist die Anzahl der Bytes, die data wirklich enthält. Ein Zeiger ohne Länge ist keine Datei, sondern eine Vermutung. Leere Dateien, fehlende Pfade und zu kurze Leseergebnisse sind normale Fälle, keine Ausnahmen am Rand.
Warum das später zählt. Parser, Disassembler und eigene Werkzeuge fangen alle damit an, dass die Bytes vollständig und mit bekannter Länge im Speicher liegen.
Übung: Implementiere load_file in den acht Schritten der Vorlage. Prüfe path und out. Initialisiere out auf { NULL, 0 }. Öffne path mit fopen(path, "rb"). Ermittle die Dateigröße und prüfe die Konvertierung zu size_t. Allokiere exakt so viele Bytes, einschließlich einer leeren Datei. Lies die gesamte Datei und erkenne einen kurzen Read. Schließe die Datei auf jedem Pfad. Übergib den Puffer nur im vollständigen Erfolgsfall an out. Eine fehlende Datei scheitert, ohne etwas doppelt freizugeben.
#include <errno.h>
#include <inttypes.h>
#include <stdbool.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

typedef struct {
    uint8_t *data;
    size_t size;
} ByteBuffer;

static void byte_buffer_destroy(ByteBuffer *buffer)
{
    if (buffer == NULL) {
        return;
    }

    free(buffer->data);
    buffer->data = NULL;
    buffer->size = 0;
}

static bool load_file(const char *path, ByteBuffer *out)
{
    /*
     * TODO:
     * 1. Prüfe path und out.
     * 2. Initialisiere out auf { NULL, 0 }.
     * 3. Öffne path mit fopen(path, "rb").
     * 4. Ermittle die Dateigröße und prüfe die Konvertierung zu size_t.
     * 5. Allokiere exakt so viele Bytes (Sonderfall: leere Datei).
     * 6. Lies die gesamte Datei und erkenne einen kurzen Read.
     * 7. Schließe die Datei auf jedem Pfad.
     * 8. Übergib den Puffer nur im vollständigen Erfolgsfall an out.
     *
     * Rückgabe: true bei Erfolg, sonst false und ein sinnvoll gesetztes errno.
     */
    (void)path;
    if (out != NULL) {
        out->data = NULL;
        out->size = 0;
    }
    errno = ENOSYS;
    return false;
}
Nimm eine Datei mit den vier Bytes 41 42 43 44. path und out sind nicht NULL, also geht der EINVAL-Zweig nicht. out startet als NULL und Länge 0, bevor fopen etwas tun kann. fopen mit rb liefert einen FILE-Zeiger. fseek ans Ende, ftell gleich 4, fseek zurück an den Anfang, und die 4 passt in eine size_t. malloc holt genau vier Byte. fread muss 4 zurückgeben. Dann fclose, und erst jetzt bekommt out den Zeiger und die Länge 4. Eine leere Datei hat ftell 0. Der Puffer bleibt NULL, die Länge bleibt 0, und das ist der Erfolg für null Bytes, nicht ein Fehler. Liefert fread nur 3, ist der Read kurz: free den Block, fclose, false, out bleibt leer. Eine fehlende Datei scheitert bei fopen, es gibt keinen Block, den du freigeben müsstest. Der eine Erfolgsweg ist der einzige, der out beschreibt.
uint32 aus vier Bytes zusammensetzen
Protokolle und Dateiformate legen Zahlen selten als fertigen C-Typ auf die Platte. Du bekommst vier Bytes und musst daraus ein uint32_t bauen, mit Schieben und Oder, ohne den Zeiger auf einen uint32_t zu casten. So bleibt sichtbar, welches Byte den höchsten Wert trägt.
Big Endian legt das höchste Byte zuerst ab, Little Endian zuletzt. Beide Formen gehören in dieselbe Übung, weil derselbe Speicher je nach Vereinbarung eine andere Zahl ist. Die Prüfung im Programm erwartet 0x12345678 und 0x78563412 für die Bytes 12 34 56 78.
Warum das später zählt. PE- und ELF-Header, Längenfelder und Offsets sind genau solche zusammengesetzten Zahlen. Wer hier rät, liest später jede Struktur falsch herum.
Übung: Fülle read_u32_be und read_u32_le. Kein memcpy und kein Pointer-Cast. Lass das Programm die beiden erwarteten Konstanten prüfen.
#include <inttypes.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>

static uint32_t read_u32_be(const uint8_t bytes[4])
{
    /* TODO: Setze die vier Bytes mit Casts, << und | zusammen. */
    (void)bytes;
    return UINT32_C(0);
}

static uint32_t read_u32_le(const uint8_t bytes[4])
{
    /* TODO: Dasselbe für Little Endian. Kein memcpy und kein Pointer-Cast. */
    (void)bytes;
    return UINT32_C(0);
}

int main(void)
{
    const uint8_t bytes[4] = {UINT8_C(0x12), UINT8_C(0x34),
                              UINT8_C(0x56), UINT8_C(0x78)};
    const uint32_t big_endian = read_u32_be(bytes);
    const uint32_t little_endian = read_u32_le(bytes);

    printf("Big Endian:    0x%08" PRIx32 " (erwartet: 0x12345678)\n",
           big_endian);
    printf("Little Endian: 0x%08" PRIx32 " (erwartet: 0x78563412)\n",
           little_endian);

    if (big_endian != UINT32_C(0x12345678)
        || little_endian != UINT32_C(0x78563412)) {
        return EXIT_FAILURE;
    }
Die vier Bytes 12 34 56 78 sind die Eingabe beider Leser. read_u32_be schiebt 12 um 24, 34 um 16, 56 um 8 und oder-verknüpft 78. Das Ergebnis ist 0x12345678. read_u32_le nimmt dieselbe Reihe von der anderen Seite: 78 ist das höchste Byte, 12 das niedrigste, und das Ergebnis ist 0x78563412. Die Prüfung in main erwartet genau diese beiden Konstanten. Ein memcpy oder ein Cast des Zeigers auf uint32_t würde die Reihenfolge dem System überlassen und die Übung aushebeln. Vertauschst du nur das erste Schieben, besteht die Prüfung nicht, obwohl alle vier Bytes noch in der Zahl stecken. Im Listing siehst du vier Ladebefehle von je einem Byte, vier Schieberegister und ein or. Welches Byte um 24 geschoben wird, entscheidet, ob der Wert die Big-Endian- oder die Little-Endian-Konstante trifft.
Little Endian und Big Endian selbst konvertieren
Endianness ist keine Eigenschaft der Zahl in der CPU, sondern der Reihenfolge auf dem Draht oder in der Datei. Diese Übung dreht eine Zahl bewusst um und wieder zurück, damit du die vier Byte-Plätze benennen kannst, ohne ein Diagramm daneben zu legen.
Wenn du nur eine Richtung kannst, verwechselst du eine Länge mit einem Offset, sobald das Format die andere Reihenfolge benutzt. Darum schreibst du beide Richtungen selbst und testest sie mit einem Wert, dessen Bytes du im Kopf sortieren kannst.
Warum das später zählt. x86-64 speichert Mehrbyte-Werte little-endian. Ein Feld, das in der Spezifikation big-endian ist, muss vor dem Vergleich gedreht werden.
Übung: Konvertiere einen festen uint32_t in beide Reihenfolgen, drucke die Bytes als Hex und prüfe, dass die Rückrichtung wieder die Ausgangszahl ergibt.
#include <inttypes.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>

static uint32_t swap_u32(uint32_t value)
{
    /* TODO: Vertausche alle vier Bytes mit Masken, <<, >> und |. */
    (void)value;
    return UINT32_C(0);
}

static void write_u32_le(uint8_t out[4], uint32_t value)
{
    /* TODO: Schreibe vom niederwertigsten zum höchstwertigen Byte. */
    (void)value;
    for (size_t i = 0; i < 4u; ++i) {
        out[i] = UINT8_C(0);
    }
}

static void write_u32_be(uint8_t out[4], uint32_t value)
{
    /* TODO: Schreibe vom höchstwertigen zum niederwertigsten Byte. */
    (void)value;
    for (size_t i = 0; i < 4u; ++i) {
        out[i] = UINT8_C(0);
    }
}

static void print_bytes(const char *label, const uint8_t bytes[4])
{
    printf("%-11s %02" PRIx8 " %02" PRIx8 " %02" PRIx8 " %02" PRIx8 "\n",
           label, bytes[0], bytes[1], bytes[2], bytes[3]);
}
Starte mit dem Wert 0x12345678. write_u32_le schreibt das niedrigste Byte zuerst: 78, dann 56, dann 34, dann 12. write_u32_be schreibt das höchste Byte zuerst: 12, 34, 56, 78. swap_u32 tauscht alle vier Plätze und liefert 0x78563412. Ein zweites swap auf dieses Ergebnis liefert wieder 0x12345678. Damit ist die Rückrichtung geprüft, nicht nur eine Richtung auswendig. Druckst du die Little-Endian-Reihe und liest sie mit der Big-Endian-Funktion, kommt 0x78563412 heraus, also der getauschte Wert, nicht der Ausgangswert. x86-64 legt Mehrbyte-Werte im Speicher little-endian ab. Ein Feld, dessen Spezifikation big-endian vorschreibt, muss vor dem Vergleich diese Drehung sehen. Im Listing sind das Masken mit 0xff, Schieben um 8, 16 und 24 und ein or, viermal, ohne einen Aufruf, der die Reihenfolge versteckt.
Einen dynamischen Byte-Vector besitzen
malloc gibt dir Speicher, aber keinen Besitzer. Diese Übung baut einen kleinen Byte-Vector, der wächst, wenn du Bytes anhängst, und der genau eine Stelle hat, die free aufruft. realloc kann die Adresse ändern. Jeder alte Zeiger auf den Block ist danach ungültig.
Halte Länge und Kapazität auseinander. Die Länge ist, was du gültig beschrieben hast. Die Kapazität ist, was das System dir geliehen hat. Wer sie vermischt, liest Müll oder schreibt hinter das Ende.
Warum das später zählt. Eigene Puffer für Dateien, Strings und Instruktionsbytes wachsen genau so. Ein zweites free oder ein Zeiger auf den alten Block ist der Fehler, den du hier einmal kontrolliert sehen sollst.
Übung: Hänge Bytes an, erzwinge mindestens ein Wachsen des Blocks und gib den Vector am Ende genau einmal frei. Prüfe auch den Fall, dass realloc scheitert und der alte Block erhalten bleibt.
#include <errno.h>
#include <stdbool.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>

typedef struct {
    uint8_t *data;
    size_t size;
    size_t capacity;
} ByteVector;

static bool byte_vector_init(ByteVector *vector, size_t initial_capacity)
{
    /*
     * TODO: Initialisiere alle Felder. Verwende für eine Kapazität > 0 calloc.
     * Bei einem Fehler muss vector einen gültigen leeren Zustand besitzen.
     */
    (void)initial_capacity;
    if (vector == NULL) {
        errno = EINVAL;
        return false;
    }
    vector->data = NULL;
    vector->size = 0;
    vector->capacity = 0;
    errno = ENOSYS;
    return false;
}

static bool byte_vector_push(ByteVector *vector, uint8_t value)
{
    /*
     * TODO:
     * - Falls size == capacity: Kapazität verdoppeln (Startwert 8).
     * - Vor der Verdopplung auf SIZE_MAX-Überlauf prüfen.
     * - realloc zuerst einem temporären Pointer zuweisen.
     * - Erst nach erfolgreicher Vergrößerung value anhängen und size erhöhen.
     */
    (void)vector;
    (void)value;
    errno = ENOSYS;
    return false;
}

static void byte_vector_destroy(ByteVector *vector)
{
    /* TODO: Speicher freigeben und alle Felder in den leeren Zustand setzen. */
    (void)vector;
}

int main(void)
{
    ByteVector vector;
    if (!byte_vector_init(&vector, 4u)) {
        perror("byte_vector_init");
        return EXIT_FAILURE;
    }

    for (size_t i = 0; i < 1000u; ++i) {
        const uint8_t value = (uint8_t)(i % 256u);
        if (!byte_vector_push(&vector, value)) {
            perror("byte_vector_push");
            byte_vector_destroy(&vector);
            return EXIT_FAILURE;
        }
    }

    for (size_t i = 0; i < vector.size; ++i) {
        if (vector.data[i] != (uint8_t)(i % 256u)) {
            fprintf(stderr, "Falscher Wert an Position %zu\n", i);
            byte_vector_destroy(&vector);
            return EXIT_FAILURE;
        }
    }

    printf("%zu Bytes gespeichert, Kapazität %zu.\n", vector.size, vector.capacity);
    byte_vector_destroy(&vector);

    if (vector.data != NULL || vector.size != 0u || vector.capacity != 0u) {
        fprintf(stderr, "destroy hat den Vector nicht vollständig geleert.\n");
        return EXIT_FAILURE;
    }

    return EXIT_SUCCESS;
}
byte_vector_init mit der Kapazität 4 legt, wenn calloc gelingt, data an, size 0 und capacity 4. Der erste push von 0 schreibt an Index 0 und setzt size auf 1. Nach vier pushes ist size gleich capacity. Der fünfte push, der Wert 4, muss wachsen: die neue Kapazität ist 8, realloc geht zuerst in einen temporären Zeiger. Ist der temporäre Zeiger NULL, bleiben data, size und capacity auf dem alten Block, und push gibt false zurück. Ist er gültig, wird data ersetzt, der Wert angehängt und size erhöht. Die Schleife bis 1000 erzwingt dieses Wachsen mehrfach, von 4 auf 8, 16, 32 und weiter, bis die Kapazität mindestens 1000 ist. data[i] muss i modulo 256 bleiben. destroy gibt genau einen Block frei und setzt data, size und capacity auf leer. Ein Zeiger, den du vor dem realloc gespeichert hast, zeigt nach einem Umzug nicht mehr auf data.
Structs aus rohen Bytes lesen
Ein struct im Quelltext hat eine Anordnung, die der Compiler mit Padding füllt. Die Bytes in einer Datei haben diese Lücken oft nicht. Diese Übung liest Felder einzeln aus einem Byte-Array, mit fester Breite und bekannter Reihenfolge, statt den Puffer auf das struct zu casten.
So siehst du jedes Feld an seinem Offset. Ein uint16_t an Offset 0 und ein uint32_t an Offset 2 sind eine Entscheidung der Spezifikation, nicht von sizeof. Padding im Speicherbild deines Prozesses darf diese Offsets nicht still verschieben.
Warum das später zählt. Header sind Tabellen von Offsets. Wer das struct aus dem Header kopiert und castet, liest auf einer anderen Architektur oder mit anderem Alignment die falschen Felder.
Übung: Lege ein kleines Byte-Array mit bekannten Werten an und fülle ein struct Feld für Feld. Drucke die Felder und vergleiche sie mit den Zahlen, die du hineingelegt hast.
#include <inttypes.h>
#include <stdbool.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>

enum ParseResult {
    PARSE_OK,
    PARSE_INVALID_ARGUMENT,
    PARSE_TOO_SHORT,
    PARSE_BAD_MAGIC
};

typedef struct {
    uint32_t magic;
    uint16_t version;
    uint16_t flags;
    uint32_t payload_size;
} Header;

uint16_t read_u16_le(const uint8_t bytes[2])
{
    /* TODO: Zwei Little-Endian-Bytes zu uint16_t zusammensetzen. */
    (void)bytes;
    return UINT16_C(0);
}

uint32_t read_u32_le(const uint8_t bytes[4])
{
    /* TODO: Vier Little-Endian-Bytes zu uint32_t zusammensetzen. */
    (void)bytes;
    return UINT32_C(0);
}

static enum ParseResult parse_header(const uint8_t *data, size_t size, Header *out)
{
    /*
     * Dateiformat (alle Zahlen Little Endian):
     * Offset  Größe  Feld
     * 0       4      magic
     * 4       2      version
     * 6       2      flags
     * 8       4      payload_size
     *
     * TODO: Argumente und Mindestgröße prüfen, jedes Feld dekodieren und magic
     * gegen 0x3142414c prüfen. out erst nach erfolgreichem Parse beschreiben.
     */
    (void)data;
    (void)size;
    (void)out;
    return PARSE_INVALID_ARGUMENT;
}

int main(void)
{
    const uint8_t raw_header[12] = {
        UINT8_C(0x4c), UINT8_C(0x41), UINT8_C(0x42), UINT8_C(0x31),
        UINT8_C(0x02), UINT8_C(0x00),
        UINT8_C(0x05), UINT8_C(0x00),
        UINT8_C(0x00), UINT8_C(0x10), UINT8_C(0x00), UINT8_C(0x00)
    };
    Header header = {0};

    const enum ParseResult result = parse_header(raw_header, sizeof(raw_header), &header);
    if (result != PARSE_OK) {
        fprintf(stderr, "Header-Parse fehlgeschlagen (Code %d).\n", (int)result);
        return EXIT_FAILURE;
    }

    printf("Magic:         0x%08" PRIx32 "\n", header.magic);
    printf("Version:       %" PRIu16 "\n", header.version);
    printf("Flags:         0x%04" PRIx16 "\n", header.flags);
    printf("Payload-Größe: %" PRIu32 " Byte\n", header.payload_size);

    if (header.magic != UINT32_C(0x3142414c)
        || header.version != UINT16_C(2)
        || header.flags != UINT16_C(5)
        || header.payload_size != UINT32_C(4096)) {
        return EXIT_FAILURE;
    }

    return EXIT_SUCCESS;
}
Die zwölf Bytes beginnen mit 4c 41 42 31. Als Little-Endian-uint32 ist das die Magic 0x3142414c. Danach liegen 02 00, also version 2, dann 05 00, also flags 5, dann 00 10 00 00, also payload_size 4096. Die Offsets sind 0, 4, 6 und 8. Ein Cast der zwölf Bytes auf das struct würde Padding zwischen den uint16-Feldern und dem folgenden uint32 einrechnen und die 4096 an der falschen Stelle lesen. parse_header prüft zuerst den Zeiger und die Mindestgröße 12. Ein Puffer von 11 Byte liefert PARSE_TOO_SHORT und schreibt out nicht. Eine andere Magic liefert PARSE_BAD_MAGIC, ebenfalls ohne out zu beschreiben. Nur PARSE_OK setzt magic, version, flags und payload_size. main vergleicht danach gegen 0x3142414c, 2, 5 und 4096. Im Listing ist jedes Feld ein eigener Lade-und-Schiebe-Block an seinem Offset, nicht ein einziger mov von zwölf Byte.
Eine eigene Binärdatei byteweise verändern
Diese Übung ändert ein Byte in einer Datei, die du selbst erzeugt hast. Es geht um Position, Länge und den Rückgabewert von fseek und fwrite, nicht darum, ein fremdes Programm umzubauen. Du suchst einen Offset, prüfst, dass er innerhalb der Datei liegt, schreibst genau ein Byte und liest die Stelle wieder.
Ein Offset ohne Prüfung schreibt an eine Stelle, die du nicht meinst. Ein Schreibfehler, den du ignorierst, lässt die Datei unverändert, während dein Programm Erfolg meldet. Darum prüfst du jeden Rückgabewert und die neue Länge.
Warum das später zählt. Wer Dateiformate versteht, kann ein Feld in einer eigenen Testdatei gezielt setzen und danach prüfen, ob der Leser es richtig deutet.
Übung: Erzeuge eine kleine Datei mit bekannten Bytes, ändere ein Byte an einem gültigen Offset und lies es zur Kontrolle zurück. Ein Offset hinter dem Ende muss scheitern, ohne die Datei zu verlängern.
#include <errno.h>
#include <inttypes.h>
#include <stdbool.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

typedef struct {
    uint8_t *data;
    size_t size;
} ByteBuffer;

static void byte_buffer_destroy(ByteBuffer *buffer)
{
    if (buffer == NULL) {
        return;
    }
    free(buffer->data);
    buffer->data = NULL;
    buffer->size = 0;
}

static bool parse_size(const char *text, size_t *out)
{
    /* TODO: strtoull mit errno, endptr und SIZE_MAX vollständig validieren. */
    (void)text;
    (void)out;
    errno = ENOSYS;
    return false;
}

static bool parse_hex_byte(const char *text, uint8_t *out)
{
    /* TODO: strtoul zur Basis 16 verwenden und nur Werte von 00 bis ff erlauben. */
    (void)text;
    (void)out;
    errno = ENOSYS;
    return false;
}

static bool load_file(const char *path, ByteBuffer *out)
{
    /* TODO: Übertrage deine robuste Lösung aus Übung 01. */
    (void)path;
    if (out != NULL) {
        out->data = NULL;
        out->size = 0;
    }
    errno = ENOSYS;
    return false;
}

static bool write_file(const char *path, const uint8_t *data, size_t size)
{
    /*
     * TODO: Mit "wb" öffnen und exakt size Bytes schreiben.
     * Prüfe fwrite und fclose. data darf nur bei size == 0 NULL sein.
     */
    (void)path;
    (void)data;
    (void)size;
    errno = ENOSYS;
    return false;
}

int main(int argc, char **argv)
{
    if (argc != 5) {
        fprintf(stderr,
                "Aufruf: %s EINGABE OFFSET BYTE_HEX AUSGABE\n"
                "Beispiel: %s input.bin 2 ff output.bin\n",
                argv[0], argv[0]);
        return EXIT_FAILURE;
    }

    size_t offset = 0;
    uint8_t replacement = 0;
    if (!parse_size(argv[2], &offset)) {
        fprintf(stderr, "Ungültiger Offset '%s': %s\n", argv[2], strerror(errno));
        return EXIT_FAILURE;
    }
    if (!parse_hex_byte(argv[3], &replacement)) {
        fprintf(stderr, "Ungültiges Byte '%s': %s\n", argv[3], strerror(errno));
        return EXIT_FAILURE;
    }

    ByteBuffer buffer = {NULL, 0};
    if (!load_file(argv[1], &buffer)) {
        fprintf(stderr, "Konnte '%s' nicht laden: %s\n", argv[1], strerror(errno));
        return EXIT_FAILURE;
    }

    if (offset >= buffer.size) {
        fprintf(stderr, "Offset %zu liegt außerhalb der Datei (%zu Byte).\n",
                offset, buffer.size);
        byte_buffer_destroy(&buffer);
        return EXIT_FAILURE;
    }

    const uint8_t old_value = buffer.data[offset];
    buffer.data[offset] = replacement;

    if (!write_file(argv[4], buffer.data, buffer.size)) {
        fprintf(stderr, "Konnte '%s' nicht schreiben: %s\n", argv[4], strerror(errno));
        byte_buffer_destroy(&buffer);
        return EXIT_FAILURE;
    }

    printf("Offset %zu: 0x%02" PRIx8 " -> 0x%02" PRIx8 "\n",
           offset, old_value, replacement);
    byte_buffer_destroy(&buffer);
    return EXIT_SUCCESS;
}
Der Aufruf mit input.bin, Offset 2, Byte ff und output.bin trifft eine Datei, die du selbst mit bekannten Bytes gefüllt hast, zum Beispiel 10 20 30 40. parse_size macht aus dem Text 2 die Länge 2. parse_hex_byte macht aus ff den Wert 255 und lehnt 100 ab, weil das über ein Byte hinausgeht. load_file aus der ersten Übung liest vier Bytes. Offset 2 ist kleiner als 4, also liegt er drin. Das alte Byte an dieser Stelle ist 30, das neue ist ff. write_file öffnet die Ausgabe mit wb, fwrite schreibt genau vier Bytes, fclose schließt. Die Ausgabe ist 10 20 ff 40, die Länge bleibt 4. Offset 4 ist nicht kleiner als die Länge. Der Zweig meldet den Fehler, destroy gibt den Puffer frei, und die Ausgabedatei wird nicht verlängert. Ein fwrite, das weniger als 4 schreibt, ist ein Fehler, keine stille Kürzung. Das ist eine Änderung an deiner Testdatei, nicht an einem Programm, das dir nicht gehört.
NASM / Assembler lernen für Cybersecurity
Level 0 — Werkzeugkasten
NASM übersetzt eine Textdatei mit Instruktionen in Bytes. gcc und der Linker machen daraus ein Programm, das du starten kannst. In dieser Lektion richtest du nur die Werkzeuge ein und prüfst, dass eine einzelne Instruktion wirklich als Byte in der Objektdatei ankommt. Du baust noch kein großes Programm. Du willst den Weg von einer Zeile Text zu einem Opcode sehen.
objdump oder ndisasm zeigt dir danach dieselben Mnemonics wieder an. Wenn die Zeile, die du geschrieben hast, und die Zeile, die das Werkzeug druckt, nicht zusammenpassen, ist der Werkzeugkasten noch nicht fertig.
Warum das später zählt. Jede weitere Lektion setzt voraus, dass du eine Assembler-Datei bauen und die Bytes wieder lesen kannst.
Aufgabe. Schreibe diese drei Zeilen, übersetze sie und lies dieselben Mnemonics mit objdump -d zurück. Wenn die Zeile im Dump nicht mov, add und ret zeigt, ist der Werkzeugkasten noch nicht fertig.
mov eax, 1
add eax, 2
ret
mov eax, 1
add eax, 2
retSchreibe die drei Zeilen mov eax, 1, dann add eax, 2, dann ret. Vor dem mov ist eax egal. Danach hält eax die 1, die obere Hälfte von rax ist durch das 32-Bit-Schreiben genullt. add eax, 2 liest diese 1, addiert 2 und lässt 3 in eax. ret kehrt mit dieser 3 zurück. Übersetzt und mit objdump -d gelesen, müssen dieselben drei Mnemonics wieder auftauchen, in dieser Reihenfolge, mit denselben Immediate-Werten 1 und 2. Fehlt das ret im Dump, ist die Datei nicht die, die du gerade übersetzt hast. Ein add mit 2, das im Dump als add mit 3 steht, ist ein anderer Quelltext, nicht ein Anzeigefehler. Dieser Durchgang prüft nur den Weg von deiner Textdatei zu den Bytes und zurück. Die 3 ist das Ergebnis der Rechnung, nicht eine Adresse.
Level 1 — Register verstehen
Register sind die benannten Speicherplätze der CPU. rax ist auf x86-64 64 Bit breit, eax sind die unteren 32 Bit, ax die unteren 16, al das untere Byte. Dieselbe Zahl kann also in einem Teil des Registers stehen, während der Rest unverändert bleibt oder, bei einer 32-Bit-Schreiboperation, genullt wird.
rsp zeigt auf den Stack, rip auf die nächste Instruktion. Die allgemeinen Register rax, rbx, rcx, rdx, rsi, rdi und r8 bis r15 halten Werte, die du gleich wieder brauchst. Es gibt keinen Variablennamen. Es gibt nur diese Plätze und den Speicher, den eine Adresse meint.
Warum das später zählt. Jede Zeile im Disassembly liest oder schreibt ein Register. Wer die Breiten verwechselt, liest aus eax einen anderen Wert als aus rax.
RE-Aufgabe, x86-64. Analysiere mov eax, edi, dann add eax, esi, dann imul eax, edx, dann ret. Rekonstruiere die C-Funktion. Das erwartete Muster ist return (a + b) * c.
mov eax, edi
add eax, esi
imul eax, edx
ret
RE-Aufgabe, RISC-V. Dieselbe Rechnung mit add a0, a0, a1 und mul a0, a0, a2. Rekonstruiere wieder return (a + b) * c.
add a0, a0, a1
mul a0, a0, a2
ret
mov rax, 0x1122334455667788
mov eax, 1Setze a auf 2, b auf 3 und c auf 4. Unter System V liegt a in edi, b in esi, c in edx. mov eax, edi kopiert 2 nach eax. add eax, esi macht 2 plus 3, also 5. imul eax, edx multipliziert 5 mit 4 und lässt 20 in eax. ret gibt 20 zurück. Das ist (a + b) * c, also (2 + 3) * 4. Dieselbe Eingabe auf RISC-V: a0 ist 2, a1 ist 3, a2 ist 4. add a0, a0, a1 schreibt 5 nach a0, mul a0, a0, a2 schreibt 20 nach a0. Die zweite Zeile der Lektion, mov rax mit 0x1122334455667788 und danach mov eax, 1, zeigt die Breite: eax wird 1, und die obere Hälfte von rax wird genullt, nicht stehengelassen. Wer nur die unteren 32 Bit liest, sieht 1. Wer rax als Ganzes erwartet und die Nullung vergisst, sucht die alten Bytes 11223344 noch über der 1.
Level 2 — Datenbewegung
mov kopiert einen Wert in ein Ziel. Die linke Seite ist das Ziel, die rechte die Quelle. lea berechnet eine Adresse und speichert sie, ohne den Speicher an dieser Adresse zu lesen. push legt einen Wert auf den Stack und zieht rsp ab, pop holt ihn zurück.
movzx und movsx erweitern einen schmalen Wert auf eine größere Breite, einmal mit Nullen, einmal mit dem Vorzeichenbit. xchg tauscht zwei Orte. Diese Instruktionen bewegen Daten. Sie entscheiden noch nicht, welcher Zweig läuft.
Warum das später zählt. Die meisten Zeilen in Compiler-Ausgabe sind Datenbewegung. Eine Funktion, die nur Werte herumreicht, besteht fast nur daraus.
Übung. Erkläre mov eax, [rdi+8] und add eax, [rdi+12], dann ret, an diesem Struct. Die Felder stehen hintereinander: a, b, c, d. Offset +8 ist c, Offset +12 ist d.
struct X {
    int a;
    int b;
    int c;
    int d;
};
mov eax, [rdi+8]
add eax, [rdi+12]
retmov rax, rbx
lea rcx, [rbx+8]
movzx eax, byte [rsi]Das Struct hält a, b, c und d als ints hintereinander. a liegt bei Offset 0, b bei 4, c bei 8, d bei 12. rdi zeigt auf das Objekt. mov eax, [rdi+8] lädt c, nicht b. Mit c gleich 9 steht danach 9 in eax. add eax, [rdi+12] lädt d. Mit d gleich 4 wird eax zu 13. ret gibt 13 zurück. Die Klammer liest Speicher. lea rdi, [rdi+8] hätte nur die Adresse von c berechnet und den Wert 9 nicht geladen. push und pop bewegen zusätzlich rsp. movzx würde ein schmales Byte mit Nullen verbreitern, movsx mit dem Vorzeichenbit. Hier sind die Felder volle ints, also reicht mov. Vertauschst du +8 und +12, addierst du d und c in der anderen Reihenfolge und bekommst bei 9 und 4 zufällig wieder 13, aber ein Feld, das kein Addieren ist, verrät die Vertauschung sofort.
Level 3 — Arithmetic Patterns
add und sub ändern ein Register um einen zweiten Operanden. imul multipliziert. idiv und div teilen, mit Rest in einem zweiten Register. shl und shr schieben Bits und multiplizieren oder teilen so durch Zweierpotenzen. and, or und xor maskieren Bits.
Compiler ersetzen eine Multiplikation mit einer kleinen Konstanten oft durch lea oder eine Folge von Schieben und Addieren. 5*x ist dann lea mit Faktor vier plus dem Original, nicht zwingend imul.
Warum das später zählt. Indexrechnung, Längen und Hash-Schritte sehen im Listing wie diese Muster aus, nicht wie die Operatoren im Quelltext.
Aufgabe. Rekonstruiere die Rechnung. shl eax, 3 ist x * 8, plus das ursprüngliche x ist return x * 9. Dieselbe Rechnung auf RISC-V ist slli t0, a0, 3 und add a0, t0, a0.
mov eax, edi
shl eax, 3
add eax, edi
slli t0, a0, 3
add a0, t0, a0
retreturn x * 9;imul eax, edi, 5
lea eax, [rdi+rdi*4]
add eax, esiDie Eingabe x ist 3 und liegt in edi, danach in eax. shl eax, 3 schiebt um drei Bit, das ist eine Multiplikation mit 8. 3 mal 8 ist 24. Das ursprüngliche x wird wieder addiert: 24 plus 3 ist 27. 27 ist 3 mal 9, also return x * 9. Dieselbe 3 auf RISC-V: slli t0, a0, 3 schreibt 24 nach t0, add a0, t0, a0 schreibt 27 nach a0. Ein imul mit 9 wäre dasselbe Ergebnis und eine andere Form. Der Compiler darf die 9 in Schieben plus Addieren falten. 5 mal x wäre lea mit dem Faktor 4 plus dem Original, nicht zwingend dieses shl um 3. Wer shl eax, 3 als Division liest, erwartet 0 und findet 24. Der Faktor steht in der Schiebeweite, das Zielregister hält danach das Produkt, nicht den alten Wert.
Level 4 — Vergleiche und Branches
cmp zieht den zweiten Operanden vom ersten ab und wirft das Ergebnis weg. Übrig bleiben die Flags. test macht dasselbe mit einem bitweisen Und. Danach springt eine bedingte Instruktion, wenn die Flags passen: je bei Gleichheit, jne sonst, jl und jg für vorzeichenbehaftete Vergleiche, jb und ja für vorzeichenlose.
Der Sprung selbst trägt die Bedingung im Mnemonik. Das Ziel ist eine Adresse oder ein Label. Ohne den vorherigen cmp oder test ist der Sprung nicht zu deuten.
Warum das später zählt. if und Schleifenenden sind im Listing genau diese Paare aus Vergleich und bedingtem Sprung.
Aufgabe. cmp und test setzen die Flags, der Sprung liest sie. Ordne je und jne der Gleichheit zu, jg und jl den vorzeichenbehafteten Vergleichen, ja und jb den vorzeichenlosen.
cmp eax, ebx
je .equal
test eax, eax
jz .empty
cmp eax, edi
jle .keep
mov eax, edicmp eax, ebx mit eax gleich 5 und ebx gleich 5 zieht 5 von 5 ab, wirft die Differenz weg und setzt das Zero-Flag. je .equal springt, jne springt nicht. Dieselbe cmp mit eax gleich 5 und ebx gleich 6 lässt das Zero-Flag gelöscht. je fällt durch, jne springt. jg und jl lesen das Vorzeichen: 5 gegen 6 ist ein jl, wenn die Zahlen vorzeichenbehaftet gelesen werden. ja und jb sind die vorzeichenlose Lesart derselben Bits. test eax, eax mit eax gleich 0 setzt ebenfalls das Zero-Flag, ohne ebx zu brauchen, und je springt. Ohne den cmp oder test davor gehört der Sprung zu älteren Flags und ist nicht die Bedingung, die du meinst. Im Quelltext ist das Paar ein if. Der Zweig, der nicht springt, ist der Fall-through in die nächste Zeile.
Level 5 — Kontrollfluss
Übung. Rekonstruiere diese Schleife. xor eax, eax und xor ecx, ecx setzen Summe und Zähler auf 0. cmp ecx, edi und jge beenden sie. Das Ergebnis heißt sum: für i von 0 bis unter n wird i addiert.
xor eax, eax
xor ecx, ecx
.loop:
cmp ecx, edi
jge .done
add eax, ecx
inc ecx
jmp .loop
.done:
ret
int sum(int n) {
int result = 0;
for (int i = 0; i < n; i++)
result += i;
return result;
}jmp springt immer. call legt die Rückkehradresse auf den Stack und springt in eine Funktion. ret holt diese Adresse zurück und springt dorthin. Eine Schleife ist ein Block, dessen letzter Sprung nach oben zeigt, oft nachdem ein Zähler verglichen wurde.
Wenn du den Graphen zeichnest, ist jede Sprungziel-Adresse ein Knoten und jeder Fall-through die Kante, die nicht springt. Eine Zeile, die nicht springt, läuft in die nächste Instruktion.
Warum das später zählt. Funktionen, Schleifen und frühe Rückgaben erkennst du an call, jmp und ret, nicht an den geschweiften Klammern, die der Compiler weggeworfen hat.
cmp ecx, 0
je .done
call accumulate
jmp .again
int sum mit n gleich 4 legt 4 in edi ab. xor eax, eax setzt die Summe auf 0. xor ecx, ecx setzt den Zähler i auf 0. cmp ecx, edi vergleicht 0 mit 4. jge .done springt nicht, weil 0 nicht größer oder gleich 4 ist. Der Körper addiert i auf die Summe: 0. i wird 1, die Summe wird 1. i wird 2, die Summe wird 3. i wird 3, die Summe wird 6. i wird 4. cmp ecx, edi ist jetzt gleich, jge springt nach .done, und eax hält 6. Die Schleife addiert i von 0 bis unter n, nicht bis einschließlich n. jmp würde immer springen und die Grenze ignorieren. call würde eine Rückkehradresse legen. Hier ist der Rückwärtssprung der Schleife das jmp nach dem Addieren, und jge ist die Kante hinaus. Für n gleich 0 ist der erste cmp schon am Ende, die Summe bleibt 0.
Level 6 — Calling Conventions
RE-Übung. Lies die drei Moves vor call mystery in der System-V-Reihenfolge. mov edx, 3, mov esi, 2, mov edi, 1, dann call mystery ist der Aufruf mystery(1, 2, 3).
mov edx, 3
mov esi, 2
mov edi, 1
call mysterymystery(1, 2, 3);Unter der System-V-AMD64-ABI, die Linux und viele Unix-Compiler nutzen, liegen die ersten sechs Integer-Argumente in rdi, rsi, rdx, rcx, r8 und r9. Der Rückgabewert steht in rax. Der Aufrufer muss den Stack vor einem call an 16 Byte ausrichten.
Windows benutzt eine andere ABI: die ersten vier Argumente liegen in rcx, rdx, r8 und r9, und der Aufrufer reserviert einen Schattenbereich. Dieselbe C-Funktion sieht deshalb in beiden Listings anders aus, obwohl der Quelltext gleich ist.
Warum das später zählt. Sobald du ein Argument suchst, musst du die ABI des Systems kennen, sonst liest du das falsche Register.
mov rdi, rax
mov rsi, rbx
call measure
mov rbx, rax
Vor call mystery stehen mov edx, 3, mov esi, 2 und mov edi, 1. Unter der System-V-ABI ist das erste int-Argument edi, das zweite esi, das dritte edx. Der Aufruf ist mystery(1, 2, 3), nicht mystery(3, 2, 1). Die 3 im letzten mov ist das dritte Argument, weil edx der dritte Platz ist. Nach dem call liegt ein Rückgabewert in eax, die Argumente in edi und esi darf der Aufrufer nicht mehr unverändert erwarten, wenn die Funktion sie benutzen durfte. Dieselbe C-Zeile unter der Windows-ABI würde 1 nach rcx, 2 nach rdx und 3 nach r8 legen, und der Aufrufer hätte 32 Byte Schattenbereich auf dem Stack. Wer die Linux-Register auf einem Windows-Listing liest, hält rcx für einen Zähler und verliert das erste Argument. Der Stack muss vor dem call an 16 Byte ausgerichtet sein. Das ändert die Argumente nicht, es ändert rsp.
Level 7 — Stackframes
Ein Frame ist der Bereich auf dem Stack, der zu einem Aufruf gehört. Die typische Prolog-Folge sichert den alten Basiszeiger, setzt rbp auf den aktuellen rsp und zieht rsp um den Platz für lokale Daten herunter. Über rbp erreichst du die Rückkehradresse und gespeicherte Register, unter rbp die lokalen Werte.
leave setzt rsp zurück auf rbp und holt den alten Basiszeiger. ret kehrt dann zurück. Nicht jede Funktion baut diesen Frame. Bei wenig Locals und Optimierung adressiert der Compiler nur über rsp.
Warum das später zählt. Lokale Variablen und gespeicherte Register liegen an festen Abständen zu rbp oder rsp. Der Frame sagt dir, welches Slot welches Objekt ist.
Aufgabe. Baue den Prolog und den Epilog. push rbp, mov rbp, rsp, sub rsp, 0x20 öffnen den Frame. leave und ret schließen ihn. Auf RISC-V ist der Anfang addi sp, sp, -32.
push rbp
mov rbp, rsp
sub rsp, 0x20
leave
ret
addi sp, sp, -32
sd ra, 24(sp)
addi s0, sp, 32push rbp
mov rbp, rsp
sub rsp, 16
mov dword [rbp-4], edi
leave
retpush rbp sichert den alten Basiszeiger. mov rbp, rsp lässt rbp auf den aktuellen Stack zeigen. sub rsp, 0x20 zieht 32 Byte für lokale Daten ab. Ein Slot bei [rbp-4] liegt in diesen 32 Byte, nicht über der Rückkehradresse. Die Rückkehradresse liegt über dem gesicherten rbp. leave setzt rsp zurück auf rbp und holt den alten rbp. Der 32-Byte-Bereich ist danach nicht mehr der Frame. ret holt die Rückkehradresse und springt dorthin. Auf RISC-V öffnet addi sp, sp, -32 dieselben 32 Byte, nur ohne rbp, wenn die Funktion den Frame-Zeiger weglässt. Eine Funktion ohne sub rsp hat keinen solchen lokalen Block. Wer [rbp-4] nach dem leave noch liest, liest Speicher, der nicht mehr dieser Aufruf ist. Der konkrete Frame dieser Lektion ist 0x20 Byte groß, nicht 0x20 Slots.
Level 8 — Lokale Variablen rekonstruieren
Eine lokale Variable ist ein Slot. Im Listing siehst du eine Adresse wie [rbp-4] oder [rsp+8], eine Breite und die Instruktionen, die dort lesen und schreiben. Dieselbe Adresse, immer mit derselben Breite, ist meist dasselbe Objekt.
Schreibe die Slots auf, bevor du ihnen Namen gibst. Vier Byte bei [rbp-4], die mit mov aus edi gefüllt werden, sind oft das erste int-Argument, das die Funktion behält. Ein Slot, der nur einmal geschrieben und nie gelesen wird, kann wegoptimiert worden sein.
Warum das später zählt. Aus Slots werden die Variablen, die du im Quelltext wiederfinden willst. Ohne die Liste rätst du bei jedem Zugriff neu.
Aufgabe. Die Slots [rbp-4] und [rbp-8] sind lokale Werte, nicht dauerhaft var_4 und var_8. Benenne sie nach der Rolle: counter, length, result, pointer oder flag.
mov DWORD PTR [rbp-4], edi
mov DWORD PTR [rbp-8], esi
mov eax, DWORD PTR [rbp-4]
add eax, DWORD PTR [rbp-8]
mov dword [rbp-4], edi
mov dword [rbp-8], esi
mov eax, [rbp-4]
add eax, [rbp-8]mov DWORD PTR [rbp-4], edi schreibt das erste Argument an den Slot vier Byte unter rbp. Kommt edi mit 7 herein, hält [rbp-4] danach 7, und zwar als Doppelwort, nicht als Byte. Ein späteres mov eax, [rbp-4] liest wieder 7. Dieselbe Adresse mit derselben Breite ist ein Objekt. [rbp-8] ist ein zweiter Slot, acht Byte unter rbp, zum Beispiel ein Zähler, der mit 0 beschrieben wird, bevor eine Schleife ihn erhöht. Ein Name var_4 beschreibt nur den Abstand. counter oder length beschreibt, dass der Slot gelesen, verglichen und erhöht wird. Ein Slot, der einmal geschrieben und nie gelesen wird, kann in einem anderen Optimierungsgrad fehlen. Schreibe zuerst 7 an [rbp-4] und 0 an [rbp-8] auf, dann die Rolle. Im Listing ist der Offset negativ, weil die Locals unter rbp liegen und die Argumente auf dem Stack, wenn sie dort liegen, darüber.
Level 9 — Pointer
Ein Zeiger ist eine Adresse in einem Register oder in einem Slot. lea lädt die Adresse eines Objekts. mov von einer Klammer liest, was dort liegt. Die Klammer ist die Dereferenzierung, das Register darin die Adresse.
Wenn eine Funktion einen Zeiger bekommt, steht die Adresse in rdi und die gelesenen Bytes kommen aus [rdi], [rdi+4] und so weiter. Die Breite des mov sagt dir, ob dort ein Byte, ein Wort oder ein Doppelwort liegt.
Warum das später zählt. Strukturen, Strings und Puffer erreichst du nur über solche Adressen. Der Zeiger selbst ist nicht der Wert, den das Programm meint.
Aufgabe. mov rax, [rdi] lädt einen Zeiger, mov eax, [rax+8] das Feld dahinter. Eine passende Rekonstruktion ist return ptr->child->value.
mov rax, [rdi]
mov eax, [rax+8]
return ptr->child->value;mov rax, rdi
mov eax, [rax]
lea rcx, [rdi+4]
mov edx, [rcx]rdi hält ptr. mov rax, [rdi] lädt das erste Feld, den Zeiger child, und liest den Speicher an ptr. Steht dort die Adresse 0x2000, ist rax danach 0x2000. mov eax, [rax+8] lädt das Doppelwort bei Offset 8 hinter child. Steht dort 15, ist eax danach 15. ret gibt 15 zurück. Die Rekonstruktion ist return ptr->child->value, mit value an Offset 8 und der Breite eines int. lea rax, [rdi] hätte die Adresse von ptr selbst geladen und den child-Zeiger nicht gelesen. Ein mov eax, [rdi+8] ohne den ersten Ladebefehl hätte ein Feld von ptr gelesen, nicht ein Feld von child. Die Klammer ist die Dereferenzierung. Zwei Klammern hintereinander sind zwei Ebenen. Die 15 ist der Wert, die 0x2000 ist nur die Adresse, über die du ihn erreichst.
Level 10 — Arrays
Ein Array ist eine Basisadresse plus ein Index mal Elementgröße. Im Listing wird aus zahlen[i] eine Rechnung: Index laden, mit der Größe multiplizieren, zur Basis addieren, dann laden. lea mit einem Faktor macht den mittleren Schritt oft in einer Zeile.
Die Basis kann ein Register sein, das die Funktion als Argument bekommen hat, oder eine Adresse auf dem Stack. Die Schleife erhöht den Index oder die Adresse, bis ein Vergleich scheitert.
Warum das später zählt. Tabellen, Sprungtabellen und Byte-Puffer sind Arrays. Die Faktor-Angabe in der Klammer verrät die Elementgröße.
Aufgabe. mov eax, [rdi+rsi*4] ist array[index], weil sizeof(int) 4 ist. Auf RISC-V wird der Index erst um 2 geschoben und dann zur Basis addiert: return array[index].
mov eax, [rdi+rsi*4]slli t0, a1, 2
add t0, a0, t0
lw a0, 0(t0)return array[index];mov eax, [rdi+rsi*4]
lea rcx, [rdi+rsi*4]
mov edx, [rcx]Die Basis des Arrays liegt in rdi, der Index in rsi. mov eax, [rdi+rsi*4] multipliziert den Index mit 4, weil ein int vier Byte hat, addiert das zur Basis und lädt das Doppelwort. Index 0 lädt [rdi], das erste Element. Index 3 lädt [rdi+12]. Bei den Werten 10, 20, 30, 40 ist das 40. Index 1 lädt 20 an Offset 4. Ein Faktor 1 wäre ein Byte-Array, ein Faktor 8 ein Array von Zeigern. Auf RISC-V schiebt slli t0, a1, 2 den Index um zwei Bit, das ist wieder mal 4. add zur Basis und lw laden dasselbe Wort. Für Index 3 ist der Offset 12, und das geladene Wort ist 40, wenn die Reihe 10, 20, 30, 40 ist. Die Schleife erhöht rsi oder die Adresse, bis der Vergleich mit der Länge scheitert. Der Faktor in der Klammer ist die Elementgröße, nicht der Index.
Level 11 — Struct Reconstruction
Übungsziel. Sammle die Offsets +0x00, +0x04 und +0x08 und rekonstruiere die Struktur. mov eax, [rdi] ist ein int bei 0, mov edx, [rdi+4] das nächste int, mov rcx, [rdi+8] ein Zeiger.
mov eax, [rdi]
mov edx, [rdi+4]
mov rcx, [rdi+8]
struct object {
int x;
int y;
void *ptr;
};Felder einer Struktur sind feste Abstände von der Basis. Das erste Feld liegt oft bei [rdi], das nächste bei [rdi+4] oder [rdi+8], je nach Breite und Ausrichtung. Du notierst Offset, Breite und welche Instruktionen das Feld lesen.
Wenn zwei Zugriffe dieselben vier Byte lesen, ist das ein Feld, kein Zufall. Ein Zugriff bei Offset 0 als Zeiger und einer bei Offset 8 als Zähler ergeben zusammen den Entwurf des struct, auch wenn du den Typnamen nicht kennst.
Warum das später zählt. Dateiheader und Objekte im Heap sind genau diese Offset-Listen. Der Typname im Quelltext ist weg, die Abstände sind geblieben.
mov rax, [rdi]
mov ecx, [rdi+8]
mov byte [rdi+12], 1
rdi zeigt auf das Objekt. mov eax, [rdi] liest vier Byte an Offset 0, ein int. Mit dem Wert 7 steht 7 in eax. mov edx, [rdi+4] liest das nächste int an Offset 4. Mit dem Wert 8 steht 8 in edx. mov rcx, [rdi+8] liest acht Byte an Offset 8, einen Zeiger. Die drei Zugriffe ergeben ein Struct mit int, int und Zeiger, die Offsets sind +0x00, +0x04 und +0x08. Ein zweites Lesen von [rdi+4] als DWORD ist dasselbe Feld, nicht ein neues. Ein Byte-Zugriff an Offset 0 wäre ein anderes Feld oder ein Teil des ersten int. Die Ausrichtung erklärt, warum nach zwei ints der Zeiger bei 8 liegt und nicht bei 6. Der Typname steht nicht im Listing. Die Rekonstruktion ist die Liste Offset, Breite, Wert: 0 hält 7, 4 hält 8, 8 hält die Adresse. Im Quelltext werden daraus zwei ints und ein Pointer, in dieser Reihenfolge.
Level 12 — Strings
Ein C-String ist eine Adresse und Bytes bis zu einem Nullbyte. Im Listing siehst du eine Schleife, die [rdi] als Byte lädt, mit 0 vergleicht und den Zeiger erhöht. strlen ist dieses Muster, auch wenn der Compiler es mit mehreren Bytes auf einmal beschleunigt.
Ein String-Literal liegt oft in einem nur lesbaren Abschnitt. lea holt seine Adresse. Der Text selbst steht nicht im Register, nur der Zeiger dorthin.
Warum das später zählt. Meldungen, Pfade und Namen erkennst du an diesem Nullbyte-Muster und an den Adressen, die lea in den Datenabschnitt führt.
Aufgabe. Beantworte zu dem String, den lea lädt: Wo befindet sich der String? Wer verwendet ihn? Welche Funktion referenziert ihn? Welche Kontrollflüsse führen dorthin?
lea rdi, [rip+message]
call puts
mov al, [rdi]
test al, al
je .end
inc rdilea rdi, [rip+message] lädt die Adresse des Literals, nicht die Zeichen selbst. Liegt dort die Bytefolge 68 69 00, also h, i und das Nullbyte, dann zeigt rdi auf das h. Eine Schleife lädt [rdi], vergleicht mit 0, erhöht rdi. Der erste Schritt sieht 68 und läuft weiter. Der zweite sieht 69 und läuft weiter. Der dritte sieht 00 und endet. Die Länge ist 2. puts bekommt dieselbe Adresse und druckt hi, ohne das Nullbyte zu zeigen. Der String liegt im lesbaren Datenabschnitt, nicht in eax. Vier Fragen gehören zu dieser Adresse: wo der String liegt, wer ihn verwendet, welche Funktion ihn referenziert, und welche Zweige dorthin führen. Ein Pfad, der an der lea vorbeigeht, benutzt diese Zeichen nicht. Im Listing ist das Nullbyte der Vergleich, der die Schleife oder puts begrenzt.
Level 13 — Switch Statements
Ein switch mit dichten Fällen wird oft eine Sprungtabelle. Der Compiler zieht den kleinsten Fall ab, vergleicht den Index mit der Anzahl der Einträge und springt sonst in den default-Zweig. Liegt der Index in der Tabelle, holt er eine Adresse und springt indirekt.
Wenige Fälle bleiben eine Kette aus cmp und je. Beides ist derselbe Quelltext. Die Dichte der Fälle entscheidet, welche Form du siehst.
Warum das später zählt. Befehlscodes und Statuswerte landen in solchen Tabellen. Der indirekte Sprung ist der Hinweis, nicht ein einzelner Vergleich.
Aufgabe. Übersetze die Sprungtabelle zurück nach switch(x). cmp edi, 5 und ja default sind der Bereichstest, jmp rax der indirekte Sprung in den Fall.
cmp edi, 5
ja default
lea rax, [rip+jump_table]
jmp rax
cmp eax, 3
ja .default
jmp qword [rax*8+.table]Der Bereichstest cmp edi, 5 und ja default lässt die Werte 0 bis 5 in die Tabelle und alles darüber in den default-Zweig. Die Eingabe 2 besteht den Vergleich, ja springt nicht, und jmp rax springt indirekt auf den Eintrag für Fall 2. Die Eingabe 9 setzt das Ergebnis über 5, ja springt nach default, und die Tabelle wird nicht gelesen. Die Eingabe 0 ist der erste Eintrag, nicht der default. Eine Kette aus cmp und je für wenige Fälle ist derselbe switch, nur ohne Tabelle. Fehlt der Bereichstest, wäre ein Index 9 ein Lesezugriff hinter der Tabelle. Der indirekte jmp rax ist der Hinweis auf die dichte Form. Der Fall, den rax trifft, ist der Körper von case 2, und der default ist der Zweig, den ja nimmt, bevor rax benutzt wird.
Level 14 — Funktionen anhand des Verhaltens erkennen
Du benennst eine unbekannte Funktion nach dem, was sie mit ihren Argumenten tut. Zwei Zeiger und eine Länge, eine Schleife, die Bytes kopiert: das Verhalten ist memcpy, auch wenn das Symbol fehlt. Ein Zähler bis zu einem Nullbyte ist strlen. Ein Vergleich, der beim ersten Unterschied abbricht, ist memcmp.
Schreibe die Argumente nach der ABI auf, dann die Schleife, dann das Ergebnis in rax. Der Name ist der letzte Schritt, nicht der erste.
Warum das später zählt. Bibliotheksfunktionen ohne Symbole erkennst du am Muster, nicht am Kommentar, den der Compiler nicht mitgeschrieben hat.
Aufgabe. Benenne die Funktion nach dem Verhalten, nicht nach einer einzelnen Instruktion. Diese Schleife bis zum Nullbyte ist eine strlen-artige Funktion.
xor eax, eax
cmp BYTE PTR [rdi+rax], 0
je .done
inc rax
mov al, [rsi]
mov [rdi], al
inc rsi
inc rdi
dec rdxDie Schleife lädt ein Byte von [rdi+rax] und vergleicht es mit 0. Für die Bytes 41 42 00, also A, B und das Nullbyte, ist rax am Anfang 0. Das Byte an Offset 0 ist 41, nicht 0, rax wird 1. Das Byte an Offset 1 ist 42, rax wird 2. Das Byte an Offset 2 ist 0, der Vergleich trifft, die Schleife endet. rax hält 2. Das ist die Länge, und das Verhalten ist eine strlen-artige Funktion, auch wenn kein Symbol strlen heißt. memcpy hätte einen zweiten Zeiger und eine Länge als Grenze, nicht ein Nullbyte. memcmp hätte zwei Zeiger und würde beim ersten Unterschied abbrechen. Der Name kommt nach dieser Beobachtung. Ein Name nach der ersten mov-Zeile würde nur das Laden beschreiben und die Länge 2 verfehlen. Das Ergebnis steht am Ende in rax, die Eingabe ist die Adresse in rdi.
Level 15 — Compiler verstehen
Dieselbe C-Funktion wird mit -O0 anders übersetzt als mit -O2. Ohne Optimierung sichert der Compiler fast jede lokale Variable auf dem Stack. Mit Optimierung bleiben Werte in Registern, verschwinden unbenutzte Rechnungen, und lea ersetzt manche Multiplikationen.
Übersetze eine kleine Funktion zweimal und lege die Listings nebeneinander. Markiere, welche Zeile im Quelltext welche Instruktionen geworden sind. Was bei -O2 fehlt, war entweder unnötig oder in eine andere Zeile gefaltet.
Warum das später zählt. Echte Programme sind optimiert. Wer nur das -O0-Muster kennt, sucht Stack-Slots, die es nicht mehr gibt.
Aufgabe. Übersetze dieselbe Funktion mit gcc -O0, -O1, -O2 und -O3. Vergleiche die Listings mit objdump -d -M intel. Markiere, was Inlining, Constant Folding oder eine andere Registerzuteilung ist.
mov eax, edi
add eax, 1
ret
lea eax, [rdi+rdi*4]
add eax, esi
retDieselbe Funktion mit der Eingabe 4 übersetzt du viermal. Bei gcc -O0 liegt die 4 oft zuerst in edi und wird sofort nach [rbp-4] gespeichert, bevor irgendeine Rechnung sie wieder lädt. Bei -O1 kann dieser Slot schon fehlen, wenn der Wert in edi lebendig bleibt. Bei -O2 und -O3 bleibt die 4 in einem Register, eine tote Zuweisung verschwindet, und eine Multiplikation mit einer Konstanten kann zu lea werden. objdump -d -M intel zeigt die vier Listings untereinander. Markiere die Zeile, die bei -O0 fünf Instruktionen braucht und bei -O2 noch zwei. Was nur in einem Listing steht, ist Inlining, Constant Folding oder eine andere Registerzuteilung, nicht eine andere Eingabe. Die 4 ist in allen vier Übersetzungen dasselbe Argument. Der Unterschied ist, wo sie zwischen mov und ret wohnt.
Level 16 — Optimierter Code
Optimierter Code rechnet in Registern und mischt die Zeilen des Quelltexts. Eine Zuweisung und die folgende Benutzung können eine Instruktion sein. Eine tote Zuweisung verschwindet ganz. Schleifen laden eine Basis einmal und erhöhen dann nur noch den Zeiger.
Lies zuerst, welche Register am Ende noch leben und nach ret gebraucht würden. Was davor überschrieben wird, ohne gelesen worden zu sein, hat der Compiler für zwischendurch benutzt.
Warum das später zählt. Die Abbildung Zeile für Zeile gilt nur ohne Optimierung. Mit -O2 musst du Werte verfolgen, nicht Zeilennummern.
Aufgabe. int multiply(int x) mit return x * 10 muss nicht imul sein. Suche lea eax, [rdi+rdi*4] und add eax, eax. Eine Instruktion ist nicht automatisch eine Quelltext-Operation.
int multiply(int x) {
    return x * 10;
}
lea eax, [rdi+rdi*4]
add eax, eax
retxor eax, eax
add eax, edi
add eax, esi
retint multiply mit return x * 10 und der Eingabe 4 muss nicht imul zeigen. lea eax, [rdi+rdi*4] rechnet 4 plus 4 mal 4, also 20, das Fünffache, ohne den Speicher zu lesen. add eax, eax verdoppelt 20 auf 40. 40 ist 4 mal 10. Eine einzelne lea wäre nur mal 5, das add macht die 10 daraus. Ein imul eax, edi, 10 würde dieselbe 40 in einer Zeile erzeugen. Beide Formen sind die Funktion. Die Zuweisung und die Benutzung sind hier keine zwei Quelltextzeilen mehr, sondern zwei Instruktionen, die den Wert 4, dann 20, dann 40 halten. Was dazwischen überschrieben wird, ohne gelesen zu werden, hat der Compiler nur kurz gebraucht. Suche die 40 am ret, nicht eine Zeilennummer aus dem -O0-Listing.
Level 17 — Flags verstehen
cmp und test schreiben die Flags und lassen die Operanden stehen. ZF ist gesetzt, wenn das Ergebnis null war, also bei Gleichheit nach cmp. SF übernimmt das Vorzeichenbit. CF und OF unterscheiden vorzeichenlose und vorzeichenbehaftete Überläufe. Die bedingten Sprünge lesen nur diese Bits.
Eine Instruktion zwischen cmp und dem Sprung kann die Flags wieder zerstören, wenn sie selbst welche schreibt. add tut das, lea nicht. Darum steht der Sprung meist direkt hinter dem Vergleich.
Warum das später zählt. Die Bedingung eines if steht nicht im jmp-Mnemonik allein. Sie steht in den Flags, die der Vergleich hinterlassen hat.
Aufgabe. sub eax, ebx schreibt die Flags, je equal liest das Zero-Flag. Zwischen Vergleich und Sprung darf keine Instruktion stehen, die die Flags wieder überschreibt.
sub eax, ebx
je equaltest eax, eax
jz .empty
cmp eax, 10
ja .too_bigsub eax, ebx mit eax gleich 5 und ebx gleich 5 schreibt die Differenz 0 nach eax und setzt das Zero-Flag. je equal liest genau dieses Flag und springt. Dieselbe sub mit eax gleich 5 und ebx gleich 2 schreibt 3 nach eax, löscht das Zero-Flag, und je fällt durch. cmp hätte die 5 in eax stehengelassen und nur die Flags gesetzt. sub verändert eax zusätzlich. Eine add-Instruktion zwischen sub und je würde die Flags neu schreiben, und der Sprung würde nicht mehr zur Differenz 0 oder 3 gehören. lea zwischen den beiden würde die Flags nicht anfassen, der Sprung bliebe gültig. Darum steht je in diesem Beispiel direkt hinter der Rechnung. ZF ist die Gleichheit, SF das Vorzeichenbit, CF und OF die Überläufe. Der Zweig equal ist der Weg, den nur die Eingabe 5 gegen 5 nimmt.
Level 18 — Signed vs Unsigned
Dieselben Bits sind als vorzeichenbehaftete oder vorzeichenlose Zahl verschieden, sobald das höchste Bit gesetzt ist. jl und jg achten auf Vorzeichen, jb und ja nicht. Eine Schleife, die eine size_t mit jge prüft, ist schon im Quelltext verdächtig, weil size_t nicht negativ wird.
imul und mul, idiv und div sind die passenden Paare für die Rechnung. Der Sprung muss zur selben Deutung gehören wie der Typ, den du rekonstruierst.
Warum das später zählt. Ein Vergleich, den du mit der falschen Vorzeichen-Regel liest, dreht eine Schleife oder eine Längenprüfung um.
Aufgabe. Dieselben Bits, zwei Sprünge. jg somewhere ist vorzeichenbehaftet, ja somewhere ist vorzeichenlos. Der Typ, den du rekonstruierst, muss zum Sprung passen.
cmp eax, ebx
jg somewhere
cmp eax, ebx
ja somewherecmp eax, edx
jb .below
cmp eax, edx
jl .lessDieselben Bits 0xffffffff in eax und 1 in ebx sind als vorzeichenbehaftete Zahl -1 und als vorzeichenlose Zahl der größte 32-Bit-Wert. jg somewhere prüft, ob -1 größer als 1 ist. Das ist falsch, der Sprung fällt durch. ja somewhere prüft, ob 0xffffffff größer als 1 ist. Das ist wahr, der Sprung wird genommen. Dieselbe cmp, zwei Zweige. Wer den Sprung ja als jg liest, dreht die Bedingung um und rekonstruiert ein int, wo size_t oder uint32_t steht. jge an einer Schleife über eine Länge ist deshalb verdächtig, wenn der Typ nicht negativ werden kann. imul und idiv gehören zur vorzeichenbehafteten Rechnung, mul und div zur vorzeichenlosen. Der Typ, den du hinschreibst, muss zum Sprung passen, der in diesem Listing wirklich steht. Die Eingabe mit gesetztem höchstem Bit ist der Fall, an dem die beiden Lesarten auseinanderlaufen.
Level 19 — Function Pointers
Ein Funktionszeiger ist eine Adresse, die call indirekt benutzt. call rax oder call [rdi] springt dorthin, wo das Register oder der Speicher hinzeigt. Der Wert kommt oft aus einer Tabelle oder aus einem Feld eines Objekts.
Vor dem indirekten call gelten dieselben Argument-Register wie vor einem normalen call. Nach dem call liegt der Rückgabewert in rax. Der Unterschied ist nur, dass das Ziel nicht als feste Adresse in der Instruktion steht.
Warum das später zählt. Callbacks und virtuelle Aufrufe sind indirekte calls. Das Ziel steht im Register, das du eine Zeile davor geladen hast.
Aufgabe. call rax und call [rbx+18h] sind indirekte Aufrufe. Das Ziel steht nicht als feste Adresse in der Instruktion. Mögliche Ursachen sind ein Callback, ein Funktionszeiger oder eine Dispatch-Tabelle.
call rax
call [rbx+18h]mov rax, [rdi]
mov rdi, rsi
call raxcall rax springt an die Adresse, die rax gerade hält, nicht an eine feste Adresse in der Instruktion. Lädst du vorher die Adresse einer Funktion, die du selbst geschrieben hast, zum Beispiel eine, die 7 zurückgibt, dann ist rax diese Adresse und eax nach dem call 7. call [rbx+18h] lädt zuerst den Zeiger an Offset 0x18 von rbx und springt dorthin. Offset 0x18 ist 24 Byte und der vierte Zeiger, Index 3, wenn jeder Eintrag acht Byte hat und die Tabelle bei 0 beginnt: die Plätze sind 0, 8, 0x10 und 0x18. Offset 0x10 wäre der dritte Eintrag. Dieselbe Stelle kann auch ein Feld in einem Objekt sein, das dort eine Adresse hält. Vor dem indirekten call gelten dieselben Argumentregister wie vor einem direkten call. Das Ziel steht eine Zeile früher im Register oder im Speicher. Ein Callback, ein Funktionszeiger oder eine Dispatch-Tabelle sind die üblichen Gründe in deinem eigenen Programm. Die Adresse ist ein Ziel, das du im Listing nachliest, keine Anleitung, ein fremdes Programm umzubiegen.
Level 20 — C++ Reverse Engineering
C++ ändert vor allem die Namen und die erste Argumentstelle. Ein Methodenaufruf bekommt this meist in rdi, wie einen versteckten ersten Parameter. Der sichtbare Name im Binary ist oft gemangelt. extern “C” lässt den Namen, wie du ihn geschrieben hast.
Eine Klasse mit virtuellen Funktionen hat eine Tabelle von Adressen. Der Aufruf lädt diese Tabelle aus dem Objekt und springt indirekt. Das Objekt selbst liegt an der Adresse in rdi, die Felder dahinter wie ein struct.
Warum das später zählt. Viele Programme sind C++. this und die Tabelle sind der Unterschied zur freien C-Funktion, nicht eine neue CPU.
Aufgabe. this liegt unter System V in rdi. mov rax, [rdi] lädt die Tabelle, call [rax+10h] ruft die Methode. Eine lesbare Form ist object->virtual_method(). Das ist ein Aufruf in deinem eigenen Programm, keine Anleitung für ein fremdes.
mov rax, [rdi]
call [rax+10h]object->virtual_method();mov rax, [rdi]
call qword [rax+16]this liegt unter System V in rdi und zeigt auf dein Objekt. mov rax, [rdi] lädt das erste Feld, die Tabelle der virtuellen Funktionen. Steht die Tabelle bei 0x3000, ist rax danach 0x3000. call [rax+10h] lädt den Zeiger an Offset 16 in dieser Tabelle und ruft ihn auf. Offset 16 ist der dritte Eintrag, wenn jeder Zeiger acht Byte breit ist und der erste bei 0 liegt. Eine lesbare Form ist object->virtual_method(). Die Felder hinter dem Tabellenzeiger im Objekt liegen wie ein Struct bei [rdi+8] und weiter. extern “C” lässt einen Funktionsnamen stehen. Ein gemangelter Name ist dieselbe Methode mit einem anderen Symbol. Der indirekte call ist der Unterschied zur freien C-Funktion, die ein direktes call mit fester Adresse hätte. Das ist ein Aufruf in dem Programm, das du selbst übersetzt hast, keine Anleitung für ein fremdes Binary.
Level 21 — Recursion
Ein rekursiver Aufruf ist ein call auf dieselbe Funktion, bevor das passende ret kam. Jeder Aufruf hat einen eigenen Frame. Die Argumente der tieferen Stufe stehen wieder in den Argument-Registern, die alten Werte müssen auf dem Stack liegen, wenn die Funktion sie noch braucht.
Die Abbruchbedingung ist ein cmp und ein Sprung, der nicht mehr callt, sondern einen festen Wert in rax legt und zurückkehrt. Ohne diese Bedingung wäre die Rekursion nur eine Endlosschleife über den Stack.
Warum das später zählt. Baumwanderungen und manche Parser rufen sich selbst. Der Frame zeigt dir die Stufe, das Argument-Register den Knoten.
Aufgabe. factorial ruft sich selbst, solange n größer als 1 ist. Im Listing suchst du einen call auf dieselbe Funktion, die gesicherten Register und den Basisfall.
int factorial(int n)
{
if (n <= 1)
return 1;
return n * factorial(n - 1);
}cmp edi, 1
jle .base
call factorialcmp edi, 1
jle .base
call walk
add eax, 1factorial von 3 ruft dieselbe Funktion mit 2, bevor das erste ret kommt. Der Aufruf mit 2 ruft sie mit 1. Der Basisfall n gleich 1, oder n nicht größer als 1, legt 1 in das Rückgaberegister und ruft nicht mehr. Der Frame für 2 multipliziert sein Argument mit dieser 1 und gibt 2 zurück. Der Frame für 3 multipliziert 3 mit 2 und gibt 6 zurück. Jeder Aufruf hat einen eigenen Frame, weil das alte n auf dem Stack oder in einem gesicherten Register liegen muss, während edi oder rdi für den tieferen Aufruf auf 2 und dann auf 1 gesetzt wird. Im Listing suchst du den call auf dieselbe Adresse, die gesicherten Register und den cmp, der bei n gleich 1 den call überspringt. Ohne diesen Vergleich würde der nächste call mit 0 oder mit einer negativen Stufe weitergehen. 6 ist das Ergebnis der Eingabe 3, nicht der Basisfall.
Level 22 — Syscalls
Ein Systemaufruf unter Linux auf x86-64 legt die Nummer in rax und die Argumente in rdi, rsi, rdx, r10, r8 und r9. Die Instruktion heißt syscall. Der Kernel schreibt das Ergebnis nach rax zurück. Das ist eine andere Konvention als ein normaler call: das vierte Argument liegt in r10, nicht in rcx.
Du musst die Nummern nicht auswendig lernen, um die Zeile zu erkennen. Du musst sehen, dass rax vor syscall eine kleine Konstante ist und die anderen Register die Werte tragen, die der Aufruf meint.
Warum das später zählt. Dateien, Speicher und Prozesse verlassen das Programm nur über diese Grenze. Im Listing ist sie eine syscall-Instruktion, kein Bibliotheksname.
Aufgabe. Vor syscall liegt die Nummer in rax und die Argumente in rdi, rsi, rdx, r10, r8 und r9. Ordne in deinem eigenen Programm die Nummer und die ersten zwei Argumente zu. Auf RISC-V ist die Nummer in a7 und die Instruktion ecall.
mov rax, 1
mov rdi, 1
syscallmov rax, 1
mov rdi, 1
syscallIn deinem eigenen Programm steht vor syscall die Nummer in rax. mov rax, 1 und mov rdi, 1 legen die Nummer 1 und das erste Argument 1 ab. Unter Linux auf x86-64 ist die Nummer 1 der Aufruf write, und rdi gleich 1 ist der Deskriptor der Standardausgabe. Das zweite Argument, der Puffer, läge in rsi, die Länge in rdx. Die Instruktion syscall selbst wechselt die Grenze. Der Kernel schreibt das Ergebnis nach rax, zum Beispiel die Anzahl der geschriebenen Bytes. Das vierte Argument eines Systemaufrufs läge in r10, nicht in rcx, anders als bei einem normalen call. Auf RISC-V läge die Nummer in a7 und die Instruktion hieße ecall. Du ordnest Nummer und die ersten zwei Argumente in der Datei zu, die du selbst übersetzt hast. Die Zeile ist die Grenze deines Programms, kein Stück, das du in ein fremdes Programm einsetzt.
Level 23 — ELF Reverse Engineering
ELF ist das Format der Programmdatei auf Linux. Am Anfang stehen Bytes, die das Format erkennen lassen, danach Kopffelder für den Einstiegspunkt, die Tabelle der Programm-Header und die Tabelle der Sektions-Header. Der Einstiegspunkt ist eine virtuelle Adresse, nicht die Dateiposition null.
In dieser Lektion liest du die Felder einer Datei, die du selbst übersetzt hast. Du suchst e_entry und vergleichst die Adresse mit der ersten Instruktion, die objdump dir für den Start zeigt.
Warum das später zählt. Bevor du eine Funktion suchst, musst du wissen, wo die Datei im Speicher liegen wird und wo die CPU beginnt.
Aufgabe. Lies an der ELF-Datei, die du selbst übersetzt hast, den Kopfeintrag mit readelf -h. Das Feld für den Einstieg ist eine virtuelle Adresse. mov eax, [rdi+24] ist nur dann dieses Feld, wenn du den Offset am Header geprüft hast.
mov eax, [rdi+24]
mov rbx, raxmov eax, [rdi+24]
mov rbx, raxreadelf -h an der ELF-Datei, die du selbst übersetzt hast, druckt den Kopfeintrag. Das Feld Entry point address ist eine virtuelle Adresse, nicht Datei-Offset 0. Liegt der Einstieg zum Beispiel bei 0x401000, beginnt die erste Instruktion, die objdump für den Start zeigt, an dieser Adresse, nicht am ersten Byte der Datei. mov eax, [rdi+24] ist dieses Feld nur, wenn rdi auf den Anfang des ELF-Kopfs zeigt. Im 64-Bit-Kopf belegen die Identifikation 16 Byte, Typ und Maschine je 2, die Version 4, und der Einstieg beginnt bei Offset 24. Ein mov an [rdi+0] lädt Identifikationsbytes, nicht die Einsprungadresse. e_phoff und e_shoff sind andere Offsets und andere Tabellen. Du vergleichst die gedruckte virtuelle Adresse mit der ersten Instruktion im Dump deiner Datei. Stimmt sie nicht, hast du den Offset am Kopf falsch gezählt.
Level 24 — PLT / GOT
RE-Aufgabe. Verfolge call puts@plt bis zum aufgelösten Ziel. Der PLT-Eintrag springt über die GOT. Beim ersten Aufruf zeigt der Slot auf den Resolver, danach auf puts selbst. Du liest nur den Weg in einem Programm, das du selbst gebunden hast.
call puts@plt
jmp qword [rel puts_got]Ein Aufruf in eine dynamische Bibliothek springt oft zuerst in die Procedure Linkage Table. Der PLT-Eintrag lädt eine Adresse aus der Global Offset Table und springt dorthin. Beim ersten Mal zeigt dieser Slot auf den Resolver, danach auf die echte Funktion.
Im Listing sieht der Aufruf aus wie call printf@plt. Die Zeilen im PLT-Stub sind kurz: ein indirekter Sprung über einen Speicheroperanden, dann ein paar Bytes für den Resolver.
Warum das später zählt. Bibliotheksaufrufe sind nicht die Funktion selbst, sondern dieser Umweg. Die GOT sagt dir, wohin der Umweg gerade zeigt.
jmp qword [rel printf_got]
push 0
jmp .resolvercall puts@plt in dem Programm, das du selbst gebunden hast, springt nicht direkt in puts. Der PLT-Eintrag springt über einen Slot in der GOT. Vor dem ersten Aufruf zeigt dieser Slot auf den Resolver. Der Resolver trägt die echte Adresse von puts in den Slot ein. Der nächste call puts@plt trifft denselben PLT-Eintrag, der indirekte Sprung landet aber auf puts. Im Dump siehst du den call, dann einen kurzen Stub mit einem indirekten jmp über den Speicheroperanden, und in der GOT die Adresse, die sich zwischen dem ersten und dem zweiten Aufruf geändert hat. Die Zeichenkette, die puts druckt, liegt weiterhin in deinem Datenabschnitt. Der Umweg erklärt nur, wohin der call geht. Du liest diesen Weg in deiner eigenen Datei nach. Der Slot ist eine Adresse, die der Binder einträgt, keine Stelle, an der du ein fremdes Programm veränderst.
Level 25 — Dynamische Analyse
Dynamisch heißt hier: du startest ein Programm, das du selbst geschrieben hast, und liest die Register an einer Stelle, die du kennst. Diese Lektion gibt dir keine Schritte gegen ein fremdes Ziel. Sie zeigt nur, welche Instruktionen du an deiner eigenen Funktion erwarten sollst, wenn ein Wert aus edi in einem Stack-Slot landet.
Setze den Quelltext daneben und markiere die eine Zeile, die dem mov entspricht. Wenn die Register nicht zu dieser Zeile passen, hast du die falsche Stelle erwischt, nicht das Programm.
Warum das später zählt. Ein Lauf bestätigt, was das Listing behauptet. Der Mini-Debugger auf der Roadmap kommt erst danach und bleibt in diesem Beitrag ein Name.
Aufgabe. Lies das Programm, das du selbst übersetzt hast. Die Kommandos zeigen Register und die Instruktionen an main, sie verändern das Programm nicht. Der Mini-Debugger bleibt unter Was danach kommt nur ein Name.
gdb ./program
break main
run
disassemble main
info registersmov dword [rbp-4], edi
mov eax, [rbp-4]
retmov dword [rbp-4], edi
mov eax, [rbp-4]
retDu startest das Programm, das du selbst übersetzt hast. gdb ./program lädt diese Datei. break main setzt den Halt auf deine main, run lässt sie bis dorthin laufen, disassemble main zeigt die Instruktionen, info registers zeigt die Register. Ein mov DWORD PTR [rbp-4], edi mit der Eingabe 7 in edi schreibt 7 an den Slot vier Byte unter rbp. Wenn info registers an dieser Stelle edi gleich 7 zeigt und der nächste Lesezugriff auf [rbp-4] wieder 7 liefert, gehört die Zeile zu diesem Argument. Zeigt edi etwas anderes, stehst du nicht auf dem mov, das du markiert hast. Die Kommandos lesen Register und Instruktionen. Sie ändern dein Programm nicht. Der Mini-Debugger bleibt unter Was danach kommt nur ein Name. Dieser Durchgang beschreibt keine Schritte für ihn und kein Vorgehen gegen ein Programm, das du nicht selbst gebaut hast.
Level 26 — Assembly ↔ C Mapping
Lege eine C-Funktion mit zwei int-Argumenten und einer Rechnung daneben und schreibe die Assembler-Zeilen, die dazu gehören, unter die System-V-ABI. edi und esi sind die Argumente, eax das Ergebnis. Eine Addition ist add, eine Multiplikation mit einer Konstanten oft lea oder imul.
Schreibe zu jeder Assembler-Zeile die C-Zeile, die sie meint. Wenn eine C-Zeile keine Assembler-Zeile hat, hat der Compiler sie entfernt oder mit der nächsten verschmolzen. Das ist eine Beobachtung, kein Fehler des Listings.
Warum das später zählt. Die Rückübersetzung ist genau diese Tabelle. Sie wird nur dann ehrlich, wenn du sie an einer Funktion übst, deren Quelltext du noch siehst.
Aufgabe. Schreibe test selbst, übersetze es, entferne die Symbole mit strip an deiner eigenen Datei und rekonstruiere die Funktion aus dem Listing. Der Quelltext, den du vergleichst, ist:
int test(int x)
{
if (x > 10)
return x * 2;
return x + 5;
}cmp edi, 10
jle .small
lea eax, [rdi+rdi]
retmov eax, edi
add eax, esi
retDie Funktion test bekommt x in edi. cmp edi, 10 vergleicht mit 10. Die Eingabe 12 ist größer als 10, jle .small springt nicht, lea eax, [rdi+rdi] rechnet 12 plus 12, also 24, und ret gibt 24 zurück. 24 ist x mal 2, der then-Zweig. Die Eingabe 4 ist nicht größer als 10, jle springt nach .small, und der andere Zweig gibt 4 plus 5, also 9, zurück. Das ist return x + 5. Beide Wege zusammen sind if (x > 10) return x * 2; sonst return x + 5. Nach strip an deiner eigenen Datei fehlen die Namen, die beiden Zweige bleiben. Eine C-Zeile ohne Gegenstück im -O2-Listing ist verschmolzen oder entfallen. Die dritte kurze Folge mov eax, edi und add eax, esi ist eine andere Rechnung, a plus b, und gehört nicht in den then-Zweig von test, solange dort lea eax, [rdi+rdi] steht.
Level 27 — Blind Function Identification
Aufgabe. Du siehst nur das Binary, ohne Source, ohne Symbole und ohne Debug-Information. Bestimme Input, Output, Data Types, Loops, Branches, Memory Access, External Calls und Function Purpose. Der Name kommt zuletzt.
Diesmal siehst du nur die Instruktionen. Notiere zuerst die Argument-Register, die gelesen werden, bevor sie überschrieben werden. Notiere dann Schleifen, Vergleiche und was in rax steht, bevor ret kommt. Erst danach wählst du einen Namen, der dieses Verhalten beschreibt.
Ein Name wie helper sagt nichts. Ein Name wie copy_bytes sagt, dass du Zeiger, Länge und eine Kopierschleife gesehen hast. Wenn du das nicht gesehen hast, darfst du den Namen nicht vergeben.
Warum das später zählt. In einem fremden Listing gibt es keine Kommentare. Die Gewohnheit, Verhalten vor dem Namen zu notieren, hält dich vom Raten ab.
mov al, [rsi]
mov [rdi], al
inc rsi
dec rdxDu siehst mov al, [rsi], mov [rdi], al, inc rsi, dec rdx, und sonst keine Namen. Die Eingabe ist ein Byte 0x41 an der Adresse in rsi, ein Ziel in rdi und eine Restlänge 3 in rdx. al wird 0x41, das Byte an rdi wird 0x41, rsi rückt um ein Byte vor, rdx wird 2. Der nächste Durchlauf kopiert das nächste Byte. Nach drei Bytes ist rdx 0, und ein folgender Vergleich auf rdx beendet die Schleife. Input sind die zwei Zeiger und die Länge. Output ist der beschriebene Zielpuffer und die 0 in rdx, wenn die Länge aufgebraucht ist. Der Datentyp der Übertragung ist ein Byte, die Schleife ist der Rücksprung, solange rdx nicht 0 ist, ein Branch ist dieser Vergleich. Der Speicherzugriff ist genau ein Byte pro Runde. Ein externer call kommt in diesen vier Zeilen nicht vor. Der Zweck ist das Kopieren von rdx Bytes, und erst dieser Satz darf den Namen tragen. helper wäre keiner.
Level 28 — Architekturvergleich
Dieselbe kleine C-Funktion übersetzt du einmal für x86-64 und einmal für RISC-V, wenn du den zweiten Compiler hast. Auf x86-64 liegen die ersten Argumente in edi und esi und das Ergebnis in eax. Auf RISC-V sind es a0 und a1, das Ergebnis wieder in a0. Die Rechnung add ist auf beiden Seiten eine Addition, die Register heißen anders.
Schreibe beide Listings untereinander und verbinde die Zeilen, die dieselbe C-Zeile meinen. Was nur auf einer Seite steht, ist eine Entscheidung des Compilers für diese Architektur, nicht ein anderes Programm.
Warum das später zählt. Wer nur eine ABI kann, liest die andere Architektur systematisch falsch. Der Vergleich an einer eigenen Funktion macht den Unterschied klein und prüfbar.
Aufgabe. Übersetze dieselbe Funktion für x86-64 und, wenn du den Compiler hast, für RISC-V. Vergleiche Instruction Set, Register Usage, Calling Convention, Compiler Strategy und Control Flow.
int foo(int a, int b)
{
return (a * 7) + b;
}imul eax, edi, 7
add eax, esi
retmov eax, edi
add eax, esi
retfoo mit a gleich 3 und b gleich 4 rechnet (a * 7) + b, also 21 plus 4, also 25. Auf x86-64 liegt 3 in edi und 4 in esi. imul eax, edi, 7 schreibt 21 nach eax. add eax, esi schreibt 25. ret gibt 25 zurück. Auf RISC-V lägen 3 in a0 und 4 in a1, eine Multiplikation mit 7 und ein Addieren von a1 würden 25 wieder in a0 lassen. Die Addition heißt auf beiden Seiten add, die Register nicht. Die Folge mov eax, edi und add eax, esi ohne das imul wäre nur 3 plus 4, also 7, und wäre eine andere Funktion. Instruction Set, Register Usage, Calling Convention, Compiler Strategy und Control Flow vergleichst du an dieser einen Eingabe. Was nur auf einer Seite steht, ist die Entscheidung des Compilers für diese Architektur. 25 muss auf beiden Seiten herauskommen, wenn beide Listings wirklich foo sind.
Level 29 — Kleine Crackmes
Aufgabe. Schreibe dieses Programm selbst. Es liest einen int mit scanf. Nur wenn der Schlüssel 1337 ist, gibt es correct aus, sonst wrong. Übersetze deine Datei mit gcc crackme.c -O2 -s -o crackme. Danach legst du den Quelltext weg und beantwortest an dem Binary, das du gerade gebaut hast, drei Fragen. Welche Eingabe wird erwartet? Wo befindet sich der Vergleich? Wie sieht der Kontrollfluss aus? Du veränderst das Programm nicht und baust keinen Schlüsselgenerator.
int main()
{
int key;
scanf("%d", &key);
if (key == 1337)
puts("correct");
else
puts("wrong");
}gcc crackme.c -O2 -s -o crackmeIm Listing deines eigenen Programms suchst du den Vergleich als Immediate.
cmp eax, 1337
je .correct
jmp .wrongcmp eax, 1337
je .correct
jmp .wrongDu schreibst das Programm selbst. scanf liest einen int nach key. Die Eingabe 1337 besteht den Vergleich key == 1337, puts schreibt correct, der else-Zweig läuft nicht. Die Eingabe 7 scheitert am Vergleich, puts schreibt wrong, und correct erscheint nicht. gcc crackme.c -O2 -s -o crackme übersetzt genau diese Datei. Danach legst du den Quelltext weg. Im Listing deines Binary suchst du das Immediate 1337. cmp eax, 1337 und je .correct ist der wahre Zweig für 1337. Der jmp .wrong oder der Fall-through daneben ist der Zweig für 7 und für jede andere Zahl. Welche Eingabe wird erwartet? 1337. Wo befindet sich der Vergleich? An diesem cmp mit dem Immediate. Wie sieht der Kontrollfluss aus? Ein Zweig nach correct, ein Zweig nach wrong. Du veränderst das Programm nicht und baust keinen Schlüsselgenerator. Die zwei Eingaben reichen, um beide Zweige am Listing deiner eigenen Datei zu benennen.
Level 30 — Reverse Engineering Challenge
Nimm eine kleine ELF-Datei, die du selbst übersetzt hast, und fülle dieses Protokoll aus. Jeder Satz muss am Listing prüfbar sein. Die Vorlage hat diese Abschnitte: Architecture, Entry Point, Functions mit Inputs, Outputs und Purpose, Data Structures, Control Flow, External Functions und Reconstructed Logic.
# Binary Analysis
## Architecture
x86-64 / RISC-V
## Entry Point
## Functions
### function_1
Inputs:
Outputs:
Purpose:
## Data Structures
## Control Flow
## External Functions
## Reconstructed LogicEine Zeile, die eine Instruktion behauptet, die nicht im Listing steht, streichst du. Das ist die Aufgabe an deinem eigenen Programm, nicht an einer Datei, die dir nicht gehört. Schreibe Architecture, Entry Point, jede Function mit Inputs, Outputs und Purpose, Data Structures, Control Flow, External Functions und Reconstructed Logic so, dass eine andere Person den Weg am Listing nachgehen kann, ohne den Quelltext zu sehen.
mov eax, edi
cmp eax, esi
jle .keep
mov eax, esiDie kleine Funktion, die du selbst übersetzt hast, beginnt mit mov eax, edi, cmp eax, esi, jle .keep, mov eax, esi. Die Eingabe a gleich 5 und b gleich 2 lässt eax zuerst 5 sein. 5 ist nicht kleiner oder gleich 2, jle fällt durch, mov eax, esi schreibt 2, und das Ergebnis ist 2, die kleinere Zahl. Die Eingabe a gleich 1 und b gleich 2 lässt eax 1 sein. 1 ist kleiner oder gleich 2, jle springt nach .keep, das mov wird übersprungen, und das Ergebnis bleibt 1, wieder die kleinere Zahl. Architecture ist x86-64. Entry Point ist die Adresse, an der diese Folge in deiner ELF-Datei liegt. Die Function hat zwei ints als Inputs, einen int als Output, und der Purpose ist das Minimum. Data Structures gibt es hier keine über die zwei Register hinaus. Control Flow ist der eine bedingte Sprung. External Functions ruft diese Folge nicht auf. Reconstructed Logic ist return a <= b ? a : b. Eine Zeile, die nicht im Listing steht, streichst du. Eine andere Person muss diesen Weg ohne deinen Quelltext nachgehen können.
Praxis-Session 1 — NASM / x86-64
lea schreibt eine berechnete Adresse in das Ziel und liest den Speicher nicht. Compiler benutzen das auch für Rechnen. lea eax, [rdi+rdi*4] ergibt rdi plus viermal rdi, also fünfmal rdi, ohne eine Speicherstelle zu berühren.
Session 1 im Wochenmodell fragt, welche mathematische Operation lea eax, [rdi+rdi*4], add eax, eax und ret ausführt. Session 2 zeigt dieselbe Rechnung auf RISC-V: slli t0, a0, 2, add t0, t0, a0, slli a0, t0, 1, ret.
lea eax, [rdi+rdi*4]
add eax, eax
retslli t0, a0, 2
add t0, t0, a0
slli a0, t0, 1
retDie konkrete Übung dieser Praxis-Session ist mystery: lea eax, [rdi+rdi*4], add eax, eax, sub eax, 3, ret. Verfolge EAX. Die Rekonstruktion ist return x * 10 - 3.
lea eax, [rdi+rdi*4]
add eax, eax
sub eax, 3
ret
int mystery(int x)
{
return x * 10 - 3;
}Unter der System-V-ABI liegt das erste int-Argument in edi. Eine Funktion, die ihr Argument mit fünf multipliziert, kann deshalb aus einem lea und einem ret bestehen. Prüfe das, indem du die Funktion in C schreibst, mit -O2 übersetzt und die eine lea-Zeile suchst.
Warum das später zählt. Wer lea nur als Adressrechnung liest, übersieht die Multiplikationen, die der Compiler dort versteckt.
lea eax, [rdi+rdi*4]
ret
Session 1 fragt nach lea eax, [rdi+rdi*4], add eax, eax und ret. Die Eingabe x gleich 4 liegt in edi. lea rechnet 4 plus 4 mal 4, also 20, das Fünffache, ohne Speicher zu lesen. add eax, eax verdoppelt auf 40. 40 geteilt durch 4 ist 10. Die Operation ist return x * 10. Session 2 auf RISC-V nimmt dieselbe 4 in a0. slli t0, a0, 2 schiebt auf 16, das Vierfache. add t0, t0, a0 macht 20, das Fünffache. slli a0, t0, 1 schiebt auf 40, wieder mal 10. mystery in der Praxis-Session hängt sub eax, 3 an die x86-64-Folge. Aus 40 werden 37. 37 ist 4 mal 10 minus 3, also return x * 10 - 3. Eine Funktion, die nur mal 5 rechnet, besteht aus der einen lea und ret und liefert für die Eingabe 4 den Wert 20, nicht 37. Wer lea nur als Adresse liest, erwartet einen Zeiger und findet 20.
Was danach kommt
Die nächsten Namen auf derselben Roadmap sind ein Mini-Debugger, ein Vulnerable-Lab und ein Mini-Fuzzer. Sie stehen hier nur als spätere Stufen. Dieser Beitrag beschreibt keine Schritte dafür.